application.yaml에 OpenAI 타임아웃을 5초로 적어 두었는데, 실제 요청은 60초까지 기다리고 있었다. Spring AI 2.0.1이 요청을 보낼 때마다 타임아웃을 기본값 60초로 다시 덮어쓰기 때문이었고, 요청 옵션에 타임아웃을 직접 넣어 해결했다. 고친 뒤에는 1초로 설정하면 정확히 1.01초에 요청이 끊긴다.
배경: 타임아웃이 왜 필요한가
식당에서 주문하면서 "15분 안에 안 나오면 취소할게요"라고 정해 두는 것과 같다. 우리 서버가 OpenAI에 질문을 보내면 답이 올 때까지 기다리는데, OpenAI가 느리거나 장애가 나면 무한정 기다릴 수는 없다.
- 사용자는 채팅창에서 계속 빈 화면을 본다.
- 기다리는 동안 서버의 일꾼(요청 스레드)이 하나씩 묶인다. 이런 요청이 쌓이면 주문·결제 같은 다른 기능까지 느려진다.
그래서 "N초 안에 답이 없으면 포기하고 '잠시 후 다시 시도해 주세요'를 보여 준다"는 규칙이 타임아웃이다. 우리 서비스는 LLM이 실패하면 공통 응답 503 AI_001을 돌려주고, 사용자가 보낸 메시지는 먼저 저장해 두는 구조라 메시지는 사라지지 않는다.
환경: Java 21, Spring Boot 4.1.1, Spring AI 2.0.1(spring-ai-starter-model-openai), OpenAI gpt-5-mini, OpenAI Java SDK 4.49.0
설정 파일에 이렇게 적어 두었다. "5초 안에 답이 없으면 포기하고, 라이브러리가 몰래 재시도하지 않게 한다"는 뜻이었다.
spring:
  ai:
    openai:
      timeout: 5s
      max-retries: 0
증상: 10초가 걸렸는데 끊기지 않았다
채팅 메시지 전송 API를 실제 OpenAI로 처음 호출했다. 답은 잘 왔지만 시간이 이상했다.
201 / 10.318281s설정대로라면 5초에서 끊겨 503이 와야 했는데, 10초를 다 기다려 성공했다. 요청 전체 시간에는 DB 저장 시간도 섞여 있어서, LLM만 얼마나 걸렸는지 DB로 따로 확인했다. 우리 서비스는 사용자 메시지를 LLM 호출 전에, AI 메시지를 호출 후에 저장하므로 두 저장 시각의 차이가 곧 LLM 응답 시간이다.
| id | sender | created_at | 이전 메세지와의 차이 |
| 25 | USER | 18:56:40.331 | |
| 26 | ASSISTANT | 18:56:50.500 | 10.17초 |
LLM 호출 하나에 10초가 걸렸는데 5초 타임아웃에 걸리지 않았다. 설정이 아무 효과가 없다는 뜻이다.
재현: 일부러 늦게 답하는 가짜 OpenAI
진짜 OpenAI는 언제 느려질지 모른다. 그래서 내 컴퓨터에 8초 뒤에 답하는 가짜 OpenAI 서버(Python 20줄)를 띄우고, 앱의 spring.ai.openai.base-url을 그 서버로 바꿔 요청을 보냈다. 가짜 서버는 받은 요청의 헤더도 출력하게 했다.
-> 201 / 8.674336s
[slowai] got /chat/completions, timeout headers: 60 / read 60- 앱은 8초를 다 기다렸다. 5초 설정이 무시된다는 게 재현됐다.
- OpenAI Java SDK는 요청에 X-Stainless-Timeout 헤더로 "나는 몇 초까지 기다릴 거야"를 적어 보낸다. 그 값이 60이었다. Spring AI의 기본값이다.
Spring AI에는 타임아웃 설정 키가 여러 개라 나머지도 하나씩 바꿔 같은 실험을 했다.
| 설정 키값 | 실제 기다린 시간 | 헹 | 헤더 |
| spring.ai.openai.timeout | 5s | 8.7초 (끝까지) | 60 |
| spring.ai.openai.chat.timeout | 5s | 8.7초 (끝까지) | 60 |
| spring.ai.openai.chat.options.timeout | 5s | 8.9초 (끝까지) | 60 |
| 코드에서 요청 옵션에 직접 5초 | 5s | 5.0초에 끊김 (OpenAIIoException) |
설정 파일로는 어떤 키도 효과가 없었고, 요청을 보낼 때 옵션에 직접 넣었을 때만 동작했다.
마지막 줄은 임시 테스트 코드로 확인했고, 같은 테스트에서 chatModel.getDefaultOptions().getTimeout()을 출력하면 PT1M(60초)이 나왔다.
원인: 요청마다 붙는 옵션이 설정을 덮어썼다
비유하자면 이렇다. 가게에 "배달은 5분 안에"라는 가게 규칙(설정 파일)을 붙여 놨다. 그런데 주문할 때마다 주문서가 새로 만들어지고, 주문서의 "배달 제한 시간" 칸에는 60분이 미리 인쇄되어 있다. 배달원은 가게 규칙이 아니라 주문서를 보고 움직이므로, 가게 규칙에 5분이라고 써도 주문서의 60분이 이긴다.
설정 파일: spring.ai.openai.timeout = 5s
     │
     ▼ 앱 시작할 때 OpenAI 연결 도구(클라이언트)에 5초 설정  ← 여기까지는 들어감
     │
     ▼ 질문을 보낼 때마다 Spring AI가 "요청 옵션"을 새로 만듦
     │   └ 요청 옵션의 timeout = 기본값 60초   ← 설정 파일 값이 여기로 안 넘어옴
     │
     ▼ 요청 옵션의 60초가 클라이언트의 5초를 덮어씀
     │
     ▼ 실제로는 60초까지 기다림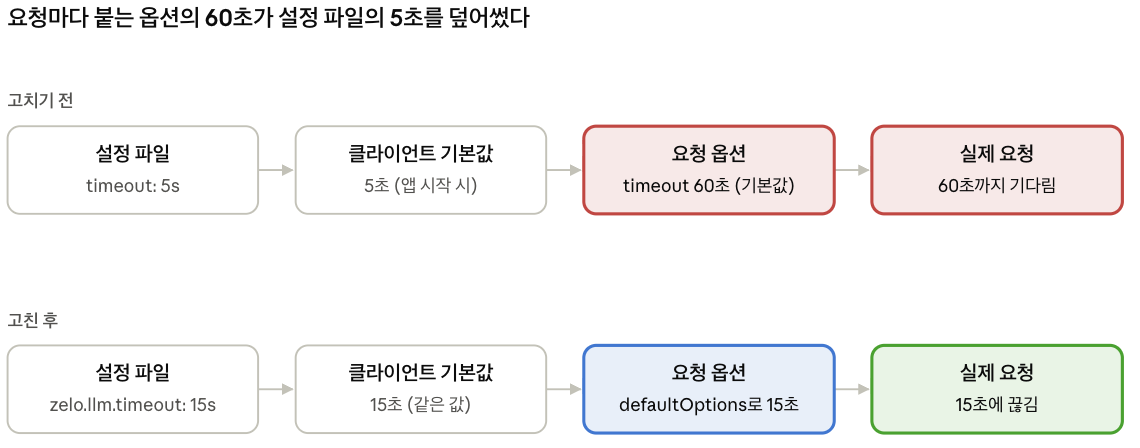
두 줄 모두 실제 요청은 요청 옵션의 값을 따른다. 고치기 전에는 그 칸이 기본값 60초였고, 고친 뒤에는 우리가 넣은 값이다.
즉 우리 코드의 실수라기보다 설정 파일만으로는 요청 타임아웃이 바뀌지 않는 Spring AI 2.0.1의 동작이다.
max-retries: 0처럼 클라이언트에만 쓰이는 설정은 요청 옵션에 덮어쓰이지 않아 그대로 동작한다.
해결: 모든 요청의 옵션에 타임아웃을 직접 넣는다
비유로 말하면 주문서에 직접 "5분"이라고 적어서 보내는 것이다. LLM을 부르는 창구인 SpringAiLlmGateway에서 ChatClient를 만들 때 기본 옵션을 달아 두었다.
public SpringAiLlmGateway(ChatClient.Builder chatClientBuilder,
                          @Value("${zelo.llm.timeout}") Duration timeout) {      // ① 설정 파일에서 값을 읽고
    this.chatClient = chatClientBuilder
            .defaultOptions(OpenAiChatOptions.builder().timeout(timeout))        // ② 모든 요청의 옵션에 넣는다
            .defaultAdvisors(new SimpleLoggerAdvisor())
            .build();
}- ① @Value로 설정 파일의 값을 읽는다. 숫자를 코드에 박지 않아서 값을 바꿀 때 설정 파일만 고치면 된다.
- ② defaultOptions(...)는 이 ChatClient로 보내는 모든 질문에 이 옵션을 기본으로 붙인다. 요청 옵션의 timeout 칸에 60초 대신 우리가 정한 값이 들어간다.
- Spring AI 2.0에서는 options(), defaultOptions()가 완성된 옵션 객체가 아니라 옵션 빌더를 받는다. .build()를 붙여 넘기면 컴파일되지 않는다.
설정 파일은 이렇게 바꿨다.
spring:
  ai:
    openai:
      max-retries: 0
      timeout: ${zelo.llm.timeout}   # 클라이언트 기본값도 같은 값으로 (값은 한 곳에서만 관리)

zelo:
  llm:
    mode: real
    timeout: 15s                      # 진짜로 적용되는 값. 여기만 바꾸면 된다
설정 이름을 zelo.llm.timeout으로 따로 만든 이유는, spring.ai.openai.timeout이 이름만 보면 적용될 것 같지만 실제로는 효과가 없었기 때문이다. 다음 사람이 같은 함정에 빠지지 않도록, 진짜로 쓰이는 값을 우리 이름으로 두고 Spring AI 설정은 그 값을 따라가게 했다.
검증: API로 직접 테스트
[변경된 코드로 인한 성공적인 타임아웃]

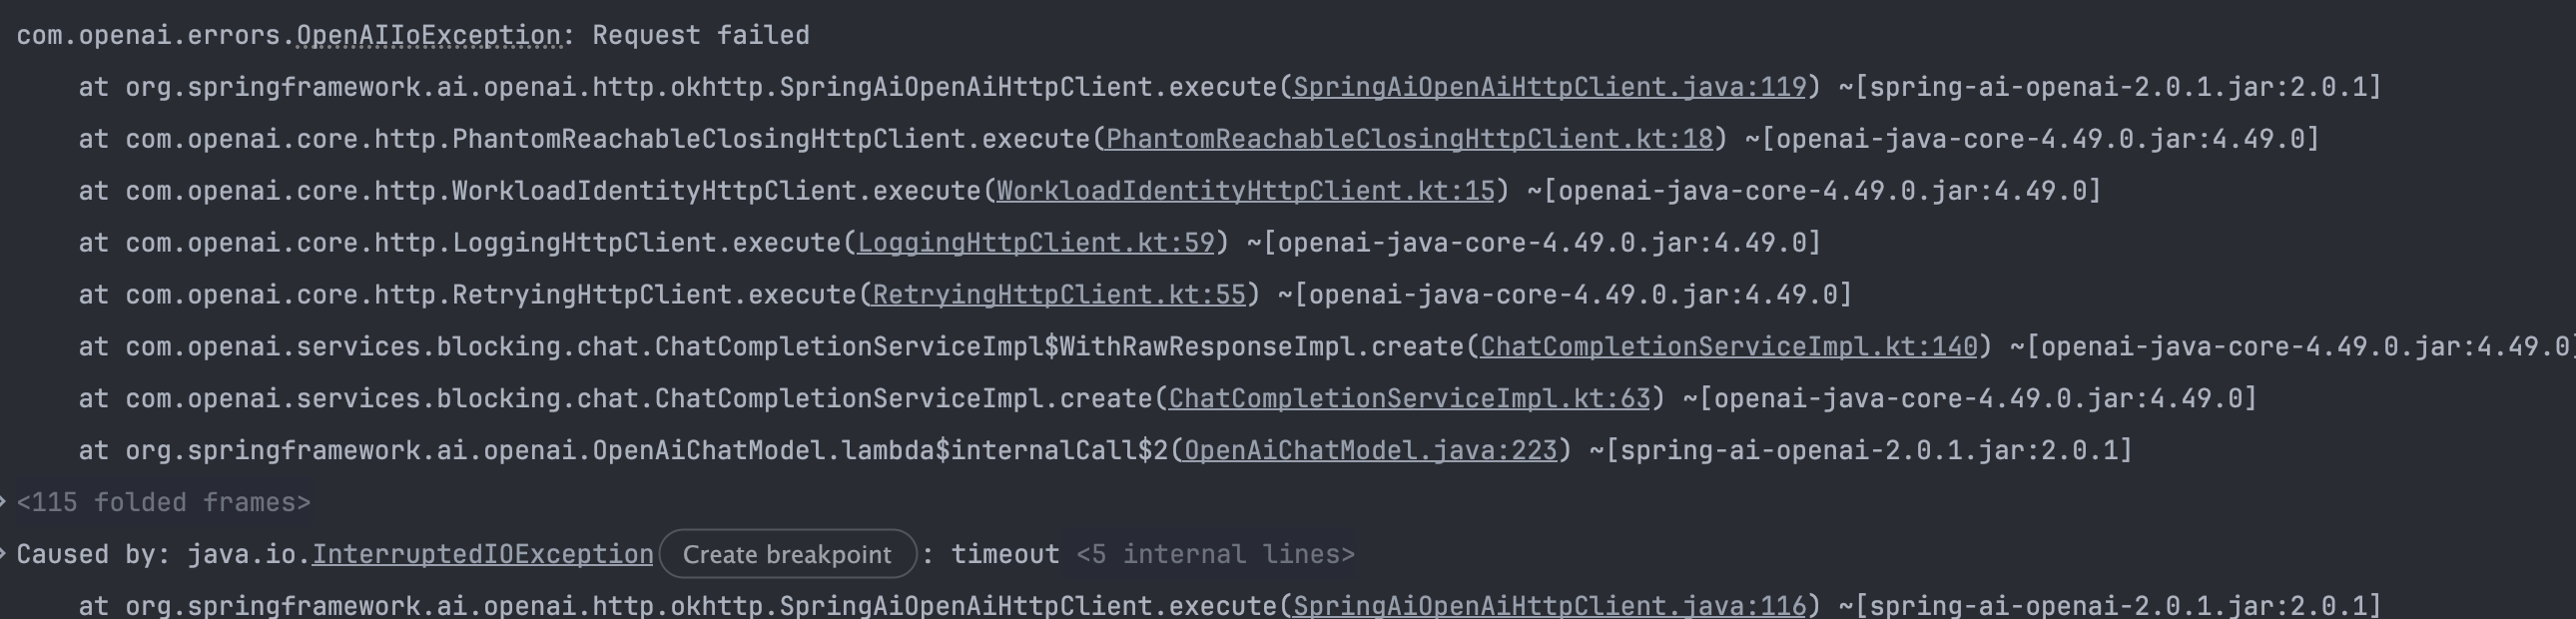
🔸타임아웃 값은 왜 15초인가
원래 계획은 5초였다. 그런데 실제 gpt-5-mini 응답이 약 10초 걸렸다. 버그를 고치면서 5초를 그대로 적용했다면, 버그가 있을 때는 성공하던 대화가 고친 뒤에는 대부분 503으로 실패했을 것이다. 그래서 일단 실측값에 여유를 둔 15초로 두었다.
타임아웃을 다시 줄이려면 응답 자체를 빠르게 해야 한다. 팀과 정할 선택지는 이렇다.
- 추론 강도(reasoning effort)를 낮춰 gpt-5-mini의 "생각하는 시간"을 줄이기. 답변 품질과의 균형 확인 필요
- 더 빠른 모델로 바꾸기. 품질·비용 비교 필요
- 타임아웃은 조금 길게 두고, 재시도 1회와 서킷 브레이커(연속 실패 시 LLM 호출을 잠시 멈춤)로 장애에 대응하기. 다음 작업인 ResilientLlmGateway에서 진행 예정
배운 점
- 설정을 적었다고 적용된 것은 아니다. 타임아웃은 정상일 때는 드러나지 않는다. 장애 상황을 일부러 만들어 보기 전까지는 동작하는지 알 수 없다.
- 외부 API의 장애는 가짜 서버로 재현한다. "8초 늦게 답하는 서버" 하나로 문제를 확신했고, 같은 방법을 테스트로 옮기니 CI에서도 매번 확인할 수 있게 됐다.
- 요청 헤더는 좋은 단서다. OpenAI Java SDK가 보낸 X-Stainless-Timeout: 60이 "설정이 어디선가 덮어써졌다"는 방향을 알려 주었다.
- 문서보다 실행이 정확하다. 공식 문서에는 spring.ai.openai.timeout이 타임아웃 설정으로 소개되어 있다. 실제 동작은 jar를 열어 요청마다 옵션을 다시 만드는 코드를 보고서야 알았다.
- 고친 뒤에는 테스트가 버그를 잡는지도 확인한다. 수정을 잠시 빼고 테스트가 실패하는지 보는 것으로 테스트가 진짜 의미가 있다는 것을 증명했다.
- 버그 수정이 다른 문제를 드러낼 수 있다. 타임아웃이 동작하지 않아서 가려져 있던 "모델 응답이 10초나 걸린다"는 문제가, 고치는 순간 당장 정해야 할 과제가 됐다.
'AI > Spring AI' 카테고리의 다른 글
| 팀 프로젝트(Zelo) - LLM 구조화 출력: 엄격 모드 도입 배경 (0) | 2026.10.24 |
|---|---|
| 서킷 브레이커 이해하기: 외부 LLM API의 장애가 우리 서비스로 번지지 않도록 (0) | 2026.10.21 |