Zelo(제로클릭 커머스)는 채팅 한 줄로 장보기를 끝내는 서비스다. 이 글은 그 안에서 사용자의 말을 "메뉴 계획"으로 정리하는 LLM을 어떤 모델로, 어떤 설정으로 쓸지를 어떻게 정했는지 기록한 것이다. 결론보다 왜 그렇게 측정했는지를 남기는 데 목적이 있다.
1. 왜 모델 테스트를 다시 하게 되었나
1-1. 서비스에서 LLM이 하는 일
사용자가 이렇게 말한다고 하자.
토요일에 초등학생 둘이랑 넷이 먹을 건데, 김치볶음밥 재료 3만 원 안에서 준비해 줘LLM은 이 말을 아래처럼 정해진 칸이 있는 객체(MenuPlan) 로 정리한다. 가격과 상품은 정하지 않는다. 그건 서버가 DB를 보고 계산한다.
intent              = SHOPPING_REQUEST   (장보기 요청)
menuName            = 김치볶음밥
servings            = 4                  (전체 인원)
budget              = 30000
ingredients         = [김치 400G, 밥 800G, 계란 4EA, 대파 1BUNCH]
conditions          = [NOT_SPICY]        (초등학생 → 맵지 않은)
unmatchedConditions = []                 (키워드로 못 나타내는 조건)
OpenAI의 구조화 출력 엄격 모드(response_format: json_schema, strict: true)로 칸의 모양을 강제하고, 서버가 한 번 더 검증한다(인원 1~20명, 재료 1~20개, 단위 일치 등).
1-2. 문제: 정상 응답이 시간 제한에 걸린다
LLM 호출은 장애에 대비해 시도당 시간 제한 5초 + 재시도 1회 + 서킷 브레이커로 감싸 두었다. 그런데 처음 쓰던 gpt-5-mini(추론 강도 기본값)의 실제 응답은 약 10초가 걸렸다. CI에서 실제 OpenAI 호출 테스트가 5초 제한에 걸려 실패하면서 드러난 사실이다.
이 상태가 만드는 문제는 두 가지다.
- 시간 제한을 그대로 두면 정상 응답도 대부분 5초에서 끊긴다. 사용자는 매번 "잠시 후 다시 말씀해 주세요"만 받는다.
- 시간 제한만 늘리면 (예: 15초) 답은 받지만 느리다. 게다가 다음 단계 설계에서는 메시지 한 번에 LLM을 두 번 부른다(메뉴 계획 → 견적 생성 → 안내 문장). 10초짜리 호출이 두 번이면 사용자는 20초를 기다린다. 장애 때는 재시도까지 더해 대기가 더 길어진다.
지금 설정으로 견적 요청 1건
  메뉴 계획(LLM) ~10초 → 견적 생성(서버) → 안내 문장(LLM) ~10초  = 약 20초
결국 "시간 제한을 몇 초로 할까"는 "어떤 모델을 어떤 설정으로 쓰느냐"가 정해져야 답할 수 있는 질문이었다. 그래서 모델과 설정부터 다시 고르기로 했다.
1-3. 왜 "그냥 빠르다는 모델"로 바꾸지 않았나
- 공식 문서에 지연 시간 수치가 없다. 가격표는 있지만 "몇 초 걸리는지"는 직접 재야 안다.
- 정확도는 우리 프롬프트에 달려 있다. 실제로 실측 전 테스트에서 "초등학생 둘이랑 넷이"를 6명으로 정리한 일이 있었다(2+4로 더함). 프롬프트에 "전체 인원 안에 따로 말한 사람은 더하지 마"라는 규칙을 넣어 고쳤다. 이처럼 같은 모델도 프롬프트 한 줄에 결과가 달라진다. 남의 벤치마크 점수로는 우리 서비스의 정확도를 알 수 없다.
- 빠르지만 틀리면 소용없다. 인원을 틀리면 재료 양이 틀리고, 결국 결제 금액이 틀린다.
그래서 "우리 프롬프트, 우리 스키마, 우리 검증 규칙"으로 직접 재기로 했다.
2. 측정 방법 설계
2-1. 한 줄 요약
평가 문장 20개 × 모델·추론 강도 조합 6개 × 3회 = 360번 호출 (+ 준비 호출 6번)
→ 조합별 정확도, 성공률, p50·p95 응답 시간, 토큰 수를 표로 비교
→ "정확도 90% 이상 중 p95가 가장 짧은 조합"을 고르고, 시간 제한 = p95 × 1.5
2-2. 앱의 실제 호출 경로를 그대로 쓰지 않은 이유
가장 쉬운 방법은 앱을 띄워 놓고 채팅을 보내면서 호출 로그(시도마다 latencyMs와 토큰 수를 남기는 로그가 이미 있다)를 모으는 것이다. 하지만 이 방법은 쓰지 않았다.
| 앱 경로의 특징 | 측정에 주는 영향 |
| 시도당 5초 시간 제한 | 느린 모델은 5초에서 끊겨 실제로 몇 초 걸리는지 알 수 없다 |
| 재시도 1회 | 실패한 호출이 두 번 기록돼 시간이 부풀려진다 |
| 모델·추론 강도가 설정 파일 값 하나로 고정 | 조합을 바꿀 때마다 앱을 다시 띄워야 한다 |
그래서 측정 코드는 앱이 보내는 요청 모양은 똑같이 쓰되(같은 프롬프트 파일, 같은 엄격 모드 스키마, 같은 검증 메서드), 시간 제한·재시도 층은 거치지 않고 모델과 추론 강도만 요청마다 바꿔 끼운다.
// 앱의 메뉴 계획 호출과 같은 모양. 옵션만 요청마다 바꾼다
OpenAiChatOptions.Builder options = OpenAiChatOptions.builder()
        .model(target.model())
        .timeout(Duration.ofSeconds(60));          // 느린 조합도 끝까지 기다려 실제 시간을 잰다
if (target.reasoningEffort() != null) {
    options.reasoningEffort(target.reasoningEffort());
}

ResponseEntity<ChatResponse, MenuPlan> response = chatClient.prompt()
        .options(options)
        .system(menuPlanPrompt.systemPrompt())     // 실제 프롬프트 파일
        .user(benchmarkCase.text())
        .call()
        .responseEntity(MenuPlan.class, ChatClient.EntityParamSpec::useProviderStructuredOutput);

MenuPlan plan = response.entity();
plan.validate(MenuPlanPrompt.INGREDIENT_UNITS);    // 앱과 같은 검증
2-3. 별도 프로젝트가 아니라 같은 프로젝트에서 잰 이유
모델 실험용 빈 프로젝트도 있었지만 쓰지 않았다.
| # | 같은 프로젝트 | 별도 빈 프로젝트 |
| 프롬프트·스키마·검증 | 실제 코드 그대로 | 복사본. 칸 하나만 달라도 결과가 달라진다 |
| 프롬프트를 고친 뒤 재측정 | 같은 코드로 바로 | 복사본을 다시 맞춰야 한다 |
| 결과의 설득력 | "실제 코드로 쟀다" | "비슷하게 만들어 쟀다" |
| 저장소 오염 | 측정 코드가 섞일 수 있음 → 로컬 전용 폴더로 git에서 제외해 해결 | 없음 |
측정 코드는 테스트 폴더 하나(ai/llm/benchmark/)에만 두고 .git/info/exclude로 저장소에서 제외했다. 실수로 돌지 않도록 환경변수 ZELO_BENCHMARK=true와 API 키가 있을 때만 실행되고, CI에서는 항상 꺼진다.
3. 왜 이 6개 조합인가
3-1. 고른 기준
메뉴 계획은 "짧은 사용자 말 → 정해진 칸 채우기" 다. 긴 글을 쓰거나 복잡한 추론을 하는 일이 아니다. 그래서 큰 모델은 후보에서 빼고, 작고 싼 모델 안에서 세 가지 질문에 답할 수 있게 골랐다.
- 지금 설정은 실제로 얼마나 느린가? (비교 기준)
- 모델을 바꾸지 않고 설정만 바꿔도 빨라지는가?
- 더 새롭고 싼 소형 모델로 바꾸면 얼마나 빨라지고, 정확도는 유지되는가?
여기에 추론 강도(reasoning effort) 를 함께 바꿨다. gpt-5 계열 모델은 답을 쓰기 전에 보이지 않는 "생각 토큰"을 만든다. 응답 시간은 만들어 내는 토큰 수에 비례하므로, 생각을 얼마나 하게 할지가 속도에 가장 큰 영향을 줄 것으로 봤다.
3-2. 6개 조합
가격은 2026-10-20 OpenAI 공식 가격표 기준(1M 토큰당 입력/출력, 달러)이다.
| # | 모델 | 추론 강도 | 고른 이유 |
| 1 | gpt-5-mini (0.25/2.00) | 기본 | 지금 쓰는 설정. 비교 기준. 기본값(문서상 medium)이 느린 원인으로 추정 |
| 2 | gpt-5-mini | low | 모델은 그대로, 생각만 줄이기. 이것만으로 충분하면 모델 교체 없이 해결되고 팀 합의도 가장 쉽다 |
| 3 | gpt-5.6-luna (0.20/1.20) | none | 더 새롭고 싼 소형 모델. 생각 토큰이 없어 가장 빠를 후보 |
| 4 | gpt-5.6-luna | low | 같은 모델에서 생각을 조금 켜면 인원·조건 정확도가 얼마나 오르는지 |
| 5 | gpt-6-luna (0.10/0.50) | none | 가장 새롭고 가장 싼 모델. Tool 호출을 추론 none에서만 지원해서, 다음 단계(견적 수정 Tool)에 같은 모델을 쓰려면 이 조합의 정확도가 중요하다 |
| 6 | gpt-6-luna | low | none과 비교해 생각을 켰을 때 정확도·속도 변화 |
3-3. 넣지 않은 모델과 이유
| 모델 | 가격 | 뺀 이유 |
| gpt-5.6-terra | 2.00/12.00 | 큰 모델. 칸 채우기에는 과하고, 느리고 비싸다 |
| gpt-5.4-mini | 0.75/4.50 | 5.6·6 세대보다 오래됐는데 더 비싸다 |
| gpt-5.4-nano, gpt-5-nano | 0.20/1.25, 0.05/0.40 | 같은 소형급을 더 새로운 luna 두 모델로 대표했다 |
| gpt-4.1-mini | 0.40/1.60 | 추론이 없는 모델이라 빠를 수 있지만 오래된 세대다. luna를 none으로 두면 "추론 없음" 조건을 새 모델로 비교할 수 있다. 결과가 기대에 못 미치면 한 줄 추가해 비교한다 |
조합을 더 늘리지 않은 이유는 시간과 비용이다. 조합 하나가 늘 때마다 호출이 60번씩 늘어난다.😅
4. 왜 이 문장 20개인가
4-1. 원칙: "실수하기 쉬운 곳"을 골고루
평균적인 문장만 넣으면 모든 모델이 비슷하게 잘한다. 차이는 헷갈리는 문장에서 난다. 그래서 메뉴 계획의 칸마다 틀리기 쉬운 경우를 넣었다.
| 유형 | 개수 | 예시 → 정답 | 확인하려는 것 |
| 인원·예산 | 4 | "초등학생 둘이랑 넷이" → 4, "어른 둘, 아이 하나" → 3, 인원 말 안 함 → 1, "만 원 안으로" → 10000 |
실제로 틀렸던 인원 계산, 기본값, 숫자 변환 |
| 조건 키워드 | 11 | "얼큰하게" → SPICY, "혈압 때문에 싱겁게" → LOW_SALT, "안 맵고 부드럽게" → NOT_SPICY + SOFT |
키워드 10개 각각 1번 이상 + 조건 2개 동시 |
| 채식 | (위에 포함) | "고기 빼고 김치찌개" → VEGETARIAN, 돼지고기·햄이 재료에 없어야 함 | 조건이 재료 선택에도 반영되는지 |
| 키워드로 못 나타내는 말 | 2 | "임산부가 먹기 좋은", "어르신 드실" → 추측하지 않고 그대로 남김 | 없는 키워드를 지어내지 않는지 |
| 장보기가 아닌 말 | 3 | "안녕하세요", "김치 보관 어떻게 해?", "김치찌개 맛있게 끓이는 팁" → 일반 질문 | 장보기와 일반 질문을 구분하는지 (요리 질문은 헷갈리기 쉽다) |
4-2. 채점 방법: 사람이 아니라 코드가 채점
메뉴 계획은 정해진 칸이 있는 구조라 정답을 코드로 비교할 수 있다. 문장마다 기대값을 적어 두고, 하나라도 다르면 오답으로 센다.
List<String> mismatches(MenuPlan plan) {
    List<String> result = new ArrayList<>();
    if (plan.intent() != intent) result.add("intent=" + plan.intent());
    if (servings != null && !servings.equals(plan.servings())) result.add("servings=" + plan.servings());
    if (budget != null && !budget.equals(plan.budget())) result.add("budget=" + plan.budget());
    if (!plan.conditions().containsAll(requiredConditions)) result.add("conditions=" + plan.conditions());
    if (expectUnmatched && plan.unmatchedConditions().isEmpty()) result.add("unmatched=[]");
    // 목록 밖 재료나 들어가면 안 되는 재료(채식의 돼지고기)는 오답
    ...
    return result;   // 비어 있으면 정답
}- 메뉴 이름과 재료 양은 채점하지 않았다. "김치볶음밥"과 "김치 볶음밥", 김치 400g과 450g은 둘 다 맞는 답이라 기계적으로 비교하면 오히려 틀린 판정이 나온다.
- 조건 키워드는 "정답이 포함되어 있는지"만 본다. "아이 먹을 거라 안 맵게"에 SOFT가 하나 더 붙는 정도는 견적 품질을 해치지 않는다.
4-3. 20개로 충분한가
충분히 많다고 할 수는 없다. 다만 이번 측정의 목적은 "모델 A와 B 중 어느 쪽이 우리 문장 유형에서 안정적인가"를 가르는 것이고, 20개면 키워드 10개와 헷갈리는 유형을 모두 한 번 이상 덮는다. 문장 수를 늘리면 조합 6개 × 3회만큼 호출이 곱으로 늘어서, 우선 이 규모로 후보를 좁히고 필요하면 후보만 문장을 늘려 다시 재기로 했다.
5. 왜 3번씩 돌렸나
5-1. LLM은 같은 질문에도 매번 다르다
같은 문장을 같은 모델에 보내도 걸리는 시간과 답이 조금씩 다르다. 서버 혼잡도에 따라 시간이 흔들리고, 답도 확률적으로 만들어진다.
- 1번만 재면 "우연히 빨랐던 1번", "우연히 틀린 1번"을 결과로 믿게 된다.
- 3번씩 재면 조합 하나당 60개(20문장 × 3회) 의 기록이 쌓인다. 이 정도면 "보통 몇 초"와 "느릴 때 몇 초"를 구분해 말할 수 있다.
- 정확도도 "3번 중 3번 맞힘"이어야 안정적이라고 본다. 결과 표에서 3번 중 한 번이라도 틀린 칸에는 * 표시를 붙였다.
5-2. 평균이 아니라 p50과 p95를 본 이유
| 지표 | 뜻 | 쓰는 곳 |
| p50 (중앙값) | 100번 중 50번째로 느린 시간 = "보통 이 정도" | 사용자 체감 |
| p95 | 100번 중 95번째로 느린 시간 = "느릴 때 이 정도" | 시간 제한 결정 |
평균은 아주 느린 한두 번에 끌려간다. 시간 제한은 "정상 응답이 거의 끊기지 않는 값"이어야 하므로 p95를 기준으로 삼고, 여유를 1.5배 둬서 zelo.llm.timeout = p95 × 1.5(올림)로 정한다.
5-3. 측정을 공정하게 만드는 장치
[준비 호출] 조합마다 1번 → 통계에서 제외
   - 첫 호출은 연결 준비, 새 스키마 처리 시간이 섞여 느리다
   - 지원하지 않는 모델·추론 강도(400 오류)는 여기서 걸러 이후 건너뛴다

[본 측정] 반복 → 문장 → 조합 순서로 번갈아 호출
   1회차: 문장1 → 조합1,2,3,4,5,6 / 문장2 → 조합1,...,6 / ... / 문장20
   2회차: 처음부터 / 3회차: 처음부터
   - 조합1을 60번 다 부르고 조합2로 넘어가면, 그 사이 OpenAI가 느려진 영향이 한 조합에만 몰린다
   - 번갈아 부르면 그런 흔들림이 모든 조합에 고르게 퍼진다

[순서대로 1개씩] 동시에 여러 요청을 보내지 않는다
   - 동시 요청은 요청 한도(rate limit)와 대기가 섞여 "응답 시간" 자체가 부정확해진다
응답 시간은 성공한 호출만 모아서 계산하고, 실패는 성공률과 정확도에 반영한다.
6. 시간과 비용
| 항목 | 깂 | 근거 |
| 호출 수 | 최대 366번 (360 + 준비 6) | 지원하지 않는 조합은 빠져서 줄어들 수 있다 |
| 걸리는 시간 | 약 20~30분 (추정) | 지금 설정이 1번에 약 10초 × 61번 ≈ 10분, 나머지 조합 합계 약 10분 |
| 비용 | 약 0.5달러 안팎 (추정) | 1번에 입력 약 1,200토큰 + 출력 수백~1,000토큰. 생각 토큰이 많으면 2~3배까지 늘 수 있지만 1~2달러를 넘기 어렵다 |
호출 1건에 1원도 안 드는 셈이라, 비용보다 "잘못 고른 모델로 서비스하는 비용"이 훨씬 크다고 판단했다.
7. 결과를 어떻게 읽고 무엇을 정하나
측정이 끝나면 아래 형식의 보고서가 콘솔과 파일(local-notes/benchmark/menu-plan-<시각>.md, 원본 CSV)로 자동 생성되도록 구성했다.
[요약] 정확도 90.0% 이상 중 p95가 짧은 순
순위  조합                판정      정확도   성공률   p50    p95    최대   입력토큰  출력토큰
1     (조합)              기준 충족  …        …        …      …      …      …         …

[p95 응답 시간] 막대가 짧을수록 빠름
 gpt-5-mini(기본)    ##############################  …s
 ...

[문장별 정답 수] 하나라도 틀린 칸은 *
문장               #1    #2    #3 ...
kid-in-total       3/3   2/3*  ...

[틀린 내용] kid-in-total → servings=6  같은 형태

[추천] (조합): 정확도 …, p95 … → zelo.llm.timeout 제안 …s
결정 규칙 (측정 전에 미리 정해 둠)
- 정확도 90% 이상인 조합만 후보로 남긴다. 특히 인원과 조건 키워드는 결제 금액과 상품 선택으로 바로 이어지므로 틀린 문장을 따로 확인한다.
- 후보 중 p95가 가장 짧은 조합을 고른다.
- 시간 제한 = 그 조합의 p95 × 1.5 (올림).
- Tool 호출을 함께 쓸 계획이라면, gpt-6-luna는 none 조합의 정확도로 판단한다.
- 기준을 넘는 조합이 없으면 모델이 아니라 프롬프트부터 고친다. 틀린 내용 목록이 어디를 고칠지 알려 준다.
- 모델 변경은 팀 합의를 거친다. 이 보고서가 그 근거 자료다.
결정 규칙을 측정 전에 정한 이유: 결과를 보고 나서 기준을 정하면, 원하는 결론에 맞춰 기준을 고르게 되기 쉽다.
8. 검토했지만 택하지 않은 방법들
| 방법 | 장점 | 단점 | 판단 |
| 유명하거나 빠르다는 모델로 바로 교체 | 시간이 안 든다 | 우리 프롬프트에서의 정확도를 모른다. 공식 지연 수치도 없다 | ✗ |
| 앱을 띄워 호출 로그로 측정 | 실제 경로 그대로 | 5초 제한에 끊겨 느린 모델의 실제 시간을 모른다. 조합마다 재시작 | ✗ |
| 별도 빈 프로젝트에서 측정 | 저장소가 깨끗하다 | 프롬프트·스키마 복사본과 실제가 어긋날 위험 | ✗ (로컬 전용 폴더로 대신 해결) |
| 동시에 여러 요청 보내기 | 몇 분 만에 끝난다 | 요청 한도와 대기가 섞여 응답 시간이 왜곡된다 | ✗ |
| 1회만 측정 | 3배 빠르고 싸다 | 조합당 20개라 p95가 흔들린다 | △ 후보 걸러내기용으로만 |
| 문장 100개 이상 | 정확도 통계가 단단해진다 | 호출이 수천 번, 시간과 비용 증가 | △ 후보를 좁힌 뒤 필요하면 |
| 사람이 직접 채점 | 미묘한 품질까지 본다 | 360개를 사람이 보기 어렵고 기준이 흔들린다. 구조화 출력이라 코드 채점이 가능 | ✗ |
| LLM에게 채점 맡기기 (LLM-as-judge) | 자유로운 문장도 채점 가능 | 채점하는 LLM도 틀린다. 정답이 칸 단위로 명확해 필요 없다 | ✗ |
모델 말고 속도를 바꾸는 다른 수단
이번 측정은 효과가 가장 클 것으로 본 추론 강도에 집중했다. 다른 수단은 다음과 같이 정리했다.
| 수단 | 효과 | 이번에 넣지 않은 이유 / 계획 |
| verbosity (답 길이) | 문장 답을 짧게 | 메뉴 계획은 칸이 정해진 JSON이라 효과가 작다. 안내 문장 호출 측정 때 함께 잰다 |
| max_completion_tokens | 출력 상한 | 속도 조절이 아니라 폭주 방지용. 너무 낮으면 JSON이 잘린다 |
| service_tier: priority | 비용을 더 내고 빠르게 | 위 방법으로 부족할 때의 최후 수단 |
| 메시지당 LLM 호출 수 줄이기 | 두 번 → 한 번이면 대기 시간이 절반 | 다음 단계 설계에서 안내 문장을 가장 빠른 설정으로 두거나 고정 문구로 대체를 검토 |
| 프롬프트 캐시 | 앞부분이 같은 긴 입력을 재사용 | 대화 기록·현재 견적을 프롬프트 뒤쪽에 붙여 캐시가 깨지지 않게 한다 |
| 스트리밍 | 첫 글자가 빨리 보임 | JSON은 전체가 와야 써서 메뉴 계획에는 효과가 없다 |
9. 이 측정의 한계
숨기지 않고 적어 둔다.
- 문장 20개, 한국어, 한 시간대의 결과다. 사용자 말이 더 다양해지면 다시 재야 한다.
- 재료 목록이 아직 임시 13개다. 실제 재료 테이블로 바뀌면 프롬프트가 길어져 시간과 정확도가 달라질 수 있다.
- 모델 이름과 가격은 2026-10-20 기준이다. 모델 지원 범위(추론 강도, 엄격 모드)는 측정의 준비 호출로 확인한다.
- 메뉴 계획 한 종류만 쟀다. 안내 문장(자유 문장)은 성격이 달라 따로 잰다.
- 측정 코드는 저장소에 올리지 않았다. 대신 측정 방법과 결정 규칙을 이 글로 남긴다.
10. 측정 결과
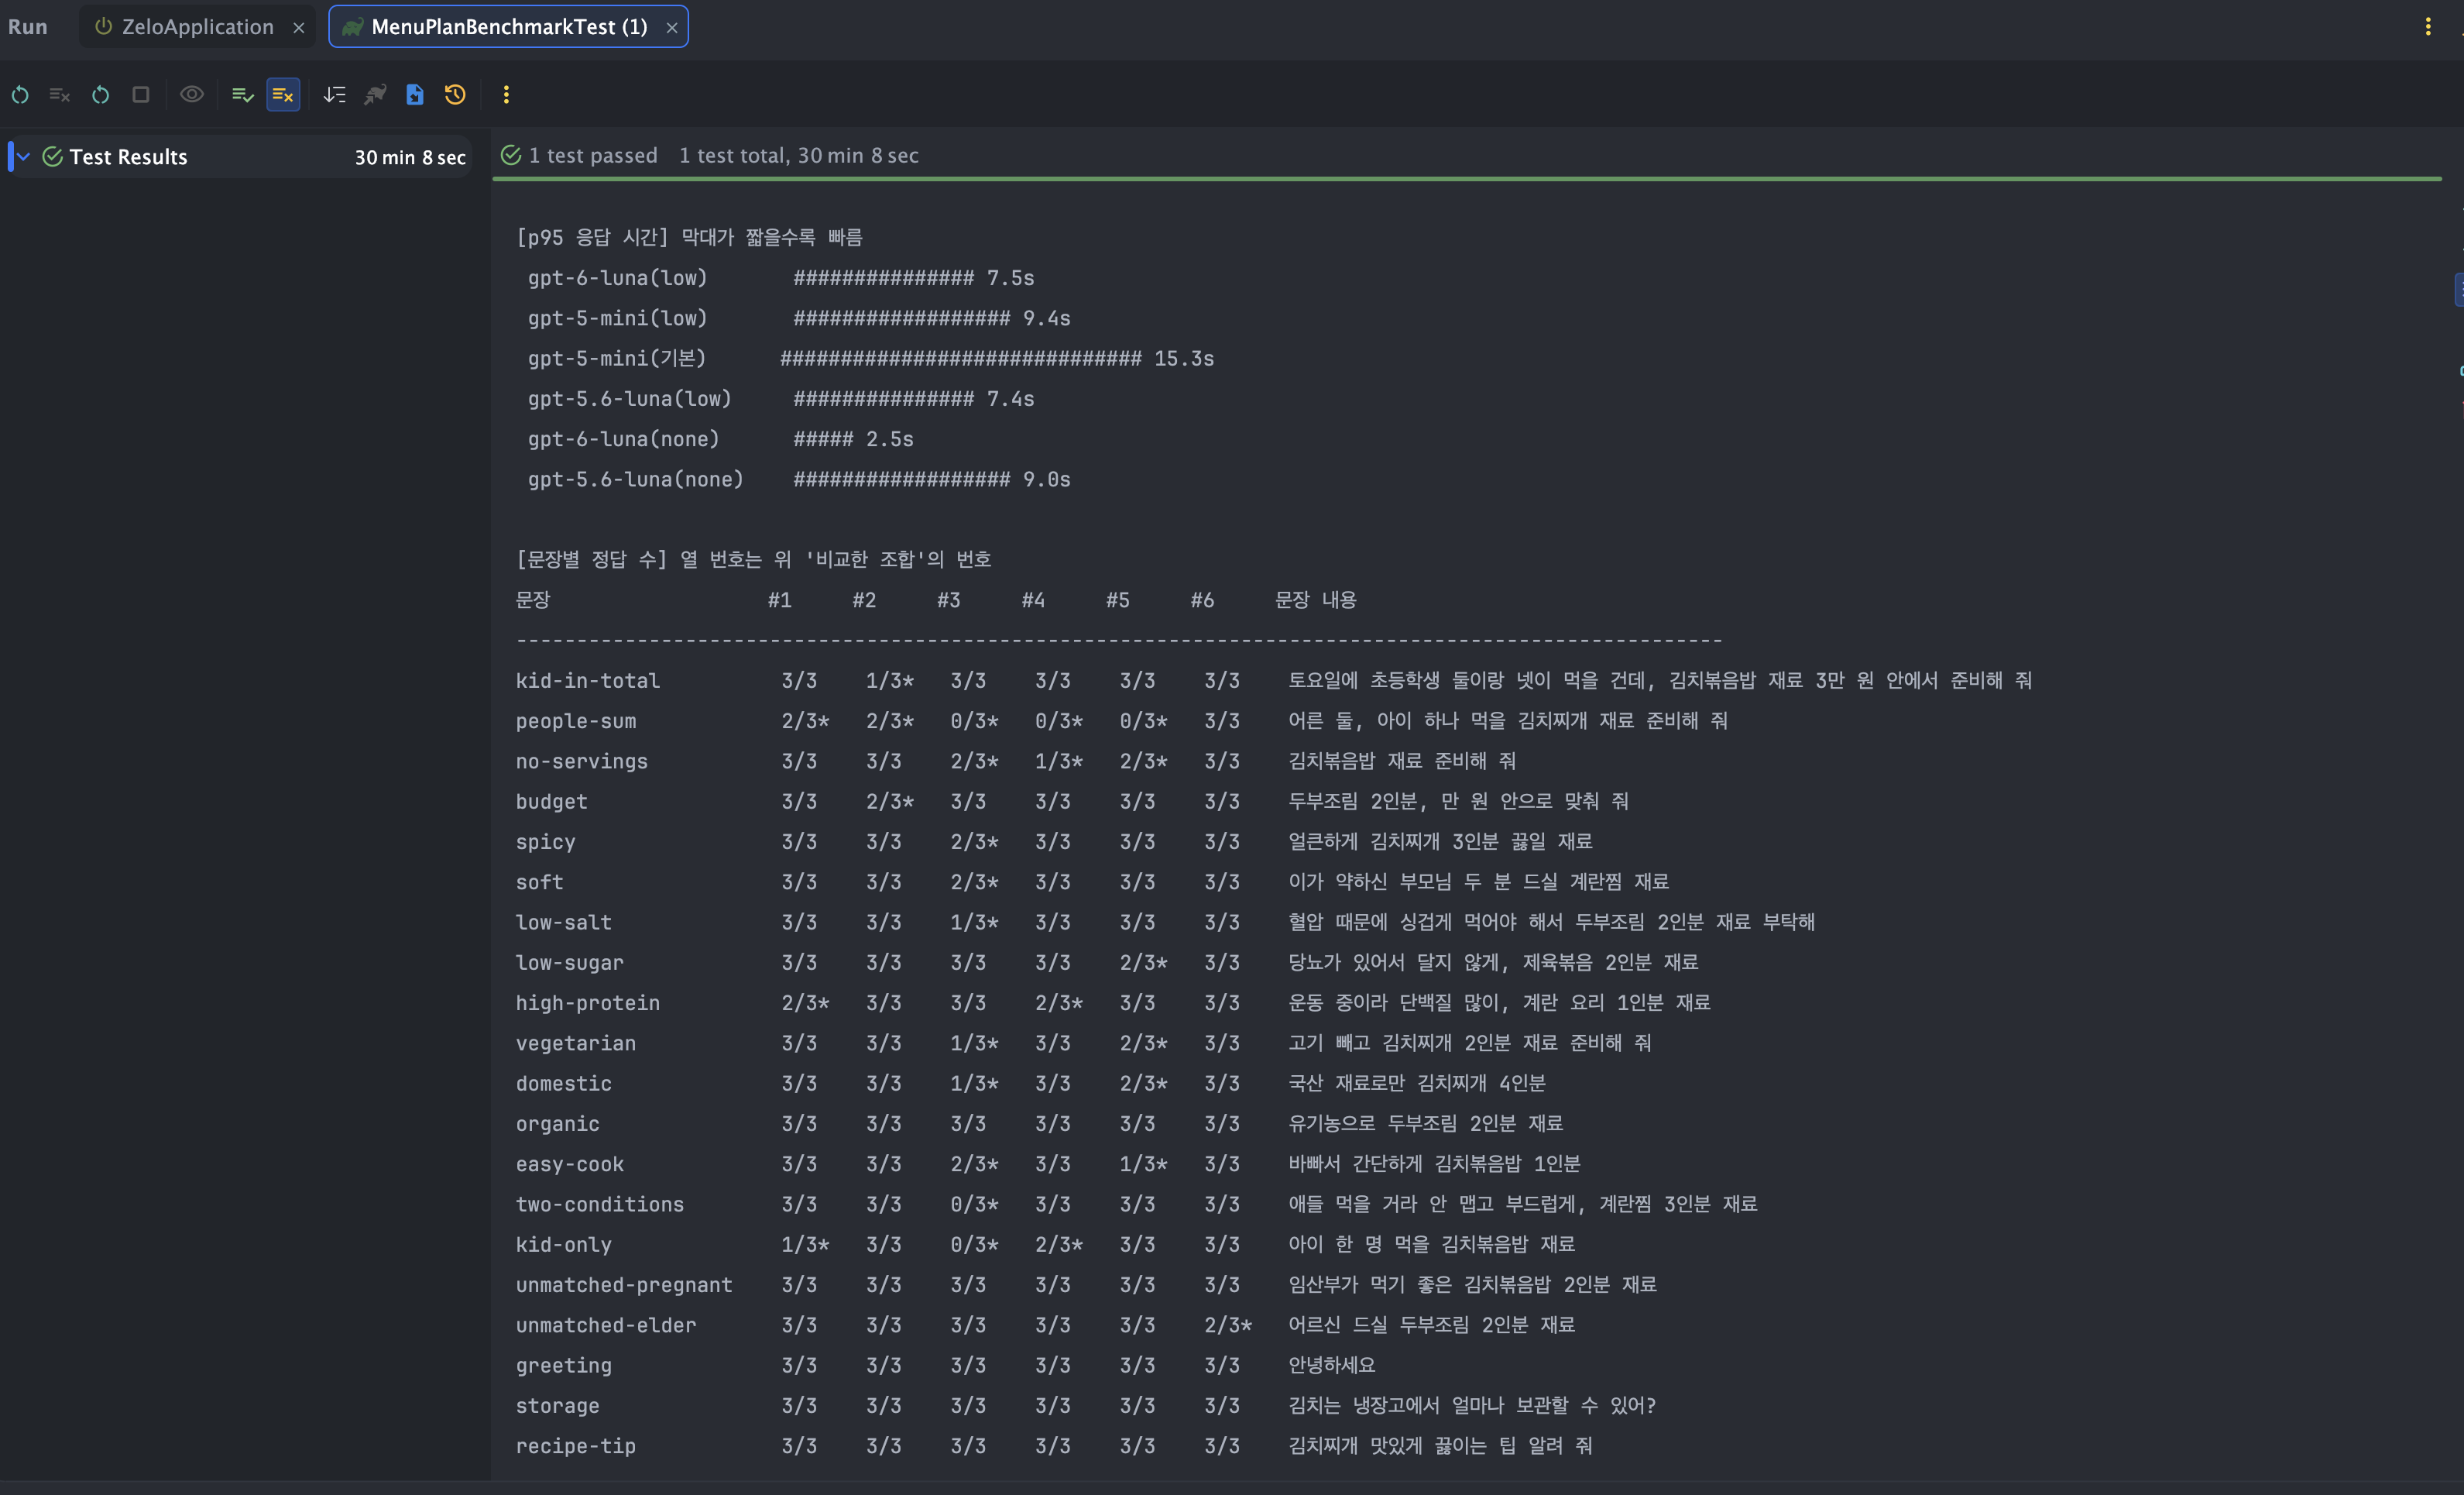
10-1. 측정 개요
| 항목 | 값 |
| 측정 시각 | 2026-10-21 22:25 (한 번의 연속 측정) |
| 호출 수 | 본 측정 360번 (20문장 × 6조합 × 3회) + 준비 호출 6번 |
| 지원 안 함으로 빠진 조합 | 없음 (6개 조합 모두 엄격 모드로 응답) |
| 걸린 시간 | 본 측정 호출 시간 합계 약 29.3분 |
| 비용 | 본 측정 약 0.27달러 (응답의 토큰 수 × 2026-10-20 가격표로 계산) |
예상했던 시간(20~30분)과 비용(0.5달러 안팎) 범위 안이었다.
10-2. 요약 표
정확도 90% 이상을 먼저, 그 안에서 p95가 짧은 순으로 정렬했다. 정확도와 성공률은 조합마다 60번 호출 기준이다.
| 순위 | 조합 | 판정 | 정확도 | 성공률 | p50 | p95 | 최대 | 평균 입력 토큰 | 평균 출력 토큰 |
| 1 | gpt-6-luna (low) | 기준 충족 | 98.3% (59/60) | 98.3% | 5.7s | 7.5s | 8.4s | 1,071 | 186 |
| 2 | gpt-5-mini (low) | 기준 충족 | 93.3% (56/60) | 98.3% | 5.7s | 9.4s | 10.1s | 1,071 | 515 |
| 3 | gpt-5-mini (기본) ← 지금 설정 | 기준 충족 | 93.3% (56/60) | 98.3% | 9.8s | 15.3s | 16.5s | 1,071 | 988 |
| 4 | gpt-5.6-luna (low) | 기준 미달 | 88.3% (53/60) | 93.3% | 3.3s | 7.4s | 8.0s | 1,072 | 181 |
| 5 | gpt-6-luna (none) | 기준 미달 | 85.0% (51/60) | 91.7% | 2.0s | 2.5s | 2.9s | 1,071 | 104 |
| 6 | gpt-5.6-luna (none) | 기준 미달 | 68.3% (41/60) | 88.3% | 2.1s | 9.0s | 11.2s | 1,072 | 114 |
- 성공률: 응답을 MenuPlan으로 받고 서버 검증까지 통과한 비율이다. 나머지는 모두 AI_009(형식·검증 실패)였다.
- 정확도: 성공한 응답 중 기대값과 모두 일치한 것만 센 비율이다(실패도 오답으로 셈).
[p95 응답 시간] 막대가 짧을수록 빠름
 gpt-6-luna(none)      #####                           2.5s
 gpt-5.6-luna(low)     ###############                 7.4s
 gpt-6-luna(low)       ###############                 7.5s
 gpt-5.6-luna(none)    ##################              9.0s
 gpt-5-mini(low)       ##################              9.4s
 gpt-5-mini(기본)      ##############################  15.3s
10-3. 결과에서 읽은 것
① 지금 설정(gpt-5-mini 기본)은 정확하지만 느리다. p50 9.8초, p95 15.3초다. 처음에 CI에서 본 "약 10초"가 측정으로 확인됐다. 시간 제한 5초로는 거의 모든 정상 응답이 끊길 수밖에 없었다. 출력 토큰이 평균 988개로 다른 조합의 약 2~10배인데, 답 자체(JSON)는 짧으므로 대부분 생각 토큰으로 볼 수 있다.
② 추론 강도만 낮춰도 빨라진다. 하지만 정확도는 그대로다. gpt-5-mini를 low로 낮추자 p50이 9.8초에서 5.7초로, 출력 토큰이 988개에서 515개로 줄었다. 정확도는 93.3%로 같았다. 모델 교체 없이 얻을 수 있는 개선이다.
③ 가장 빠른 조합(gpt-6-luna none, p95 2.5초)은 정확도 기준을 넘지 못했다. 틀린 내용을 보면 이유가 분명하다.
- 재료 목록에 없는 "물" 을 재료로 넣었다. "목록에 있는 이름만 쓰라"는 규칙을 어긴 것이다.
- 60번 중 5번이 AI_009(검증 실패)였다.
추론을 끈 gpt-5.6-luna(none)도 같은 경향이 더 강했다. 목록 밖 재료가 10번("물" 9번, "소금" 1번) 나왔고 정확도는 68.3%였다. 추론을 끄면 빨라지지만, 프롬프트의 제약을 지키는 힘이 약해진다는 것을 보여 준다.
④ 결정 규칙에 따른 추천: gpt-6-luna (low)
- 정확도 98.3%로 6개 조합 중 가장 높고, 틀린 것은 60번 중 1번(AI_009)뿐이다. 하나라도 틀린 문장이 1개뿐인 유일한 조합이다.
- 지금 설정과 비교하면 p50이 9.8초에서 5.7초(약 42% 단축), p95가 15.3초에서 7.5초(약 51% 단축)로 줄었다.
- 출력 토큰이 988개에서 186개로 줄고 가격도 싸서, 이번 측정의 호출 1건당 비용이 약 0.0022달러에서 약 0.0002달러로 약 11분의 1이 됐다.
- 시간 제한 제안: p95 7.5초 × 1.5 = 11.25초 → 12초
⑤ 자주 틀린 문장: "어른 둘, 아이 하나" gpt-6-luna(low)를 뺀 모든 조합이 이 문장의 조건 키워드를 비우는 일이 있었다. 우리 프롬프트는 "아이 → NOT_SPICY"를 예시로 들지만, 모델들은 "어른도 함께 먹는다"는 점 때문에 조건을 붙이지 않은 것으로 보인다. 이건 모델의 실수라기보다 우리 기대값이 논쟁적인 문장일 수 있다. 어른과 아이가 함께 먹을 때 맵지 않은 상품을 고를지는 서비스 정책으로 정해야 하고, 정한 뒤 프롬프트 예시에 명확히 넣을 계획이다.
인원 함정 문장("초등학생 둘이랑 넷이")은 프롬프트에 인원 규칙을 추가한 뒤에도 gpt-5-mini(low)가 3번 중 1번 6명으로 답했다. gpt-6-luna(low)는 3번 모두 4명으로 맞혔다.
10-4. 결정과 남은 일
| 항목 | 내용 |
| 추천 조합 | gpt-6-luna, 추론 강도 low (결정 규칙 1·2번 적용) |
| 시간 제한 제안 | 12초 (p95 7.5초 × 1.5, 올림) |
| 반영 방식 | 모델 변경은 팀 합의 후 설정에 반영 |
| Tool 경로 | gpt-6-luna는 Tool 호출을 none에서만 지원한다. 메뉴 계획은 low로 쓰고, Tool을 쓰는 견적 수정은 호출마다 옵션을 따로 두거나 다른 모델을 쓰는 방안을 별도로 측정한다. none의 정확도(85.0%)는 메뉴 계획에는 부족했다 |
| 프롬프트 개선 | "어른과 아이가 함께 먹을 때"의 조건 정책을 정해 예시에 추가, 목록 밖 재료("물", "소금")를 넣지 않도록 규칙 강조 |
10-5. 결과를 볼 때 주의할 점
- 한 번의 연속 측정이다. 다른 시간대에는 응답 시간이 달라질 수 있다.
- 조합당 성공한 호출 약 53~59개로 p95를 계산했다. 순위를 뒤집을 만큼은 아니지만 0.x초 단위 차이(예: 7.4초와 7.5초)에 의미를 두기는 어렵다.
- AI_009가 형식 오류인지 검증 실패인지는 이번 기록에 구분해 남기지 않았다. 엄격 모드에서는 형식 오류가 거의 없으므로 대부분 검증 실패(예: 범위 밖 값)로 추정한다.
- 비용은 응답에 찍힌 토큰 수와 가격표로 계산한 값이다. 실제 청구액은 OpenAI 대시보드 기준이다.
정리
- LLM 설정은 "빠르다더라"가 아니라 우리 프롬프트로 직접 잰 숫자로 정한다.
- 비교 대상은 작업 성격(칸 채우기)에 맞는 소형 모델로 좁히고, 속도에 가장 큰 영향을 주는 추론 강도를 함께 바꿨다.
- 평가 문장은 실제로 틀렸던 곳과 틀리기 쉬운 곳을 중심으로 고르고, 정답은 코드로 채점했다.
- 3번씩, 번갈아, 하나씩 불러 우연과 시간대의 영향을 줄였다.
- 결정 규칙은 측정 전에 정했다. 정확도 90% 이상 중 p95가 가장 짧은 조합, 시간 제한은 p95 × 1.5.
'AI > LLM' 카테고리의 다른 글
| 결제 알림이 AI 응답에 섞인 이유: Chat Completions API의 Role 기반 메시지 분리 (0) | 2026.10.25 |
|---|---|
| 팀 프로젝트(Zelo) - 리뷰 모델 변경 테스트 및 결정 (0) | 2026.10.22 |