Spring Boot 프로젝트를 만들었다면 내 컴퓨터에서는 IntelliJ의 실행 버튼만 눌러도 서버가 동작한다.
그런데 이 프로젝트를 팀원의 컴퓨터나 배포 서버로 옮기면
Java를 설치하고, 버전을 확인하고, MySQL을 준비하고, 실행에 필요한 설정도 맞춰야 한다.
소스 코드는 Git으로 공유했지만, 그 코드를 실행할 환경까지 전달한 것은 아니기 때문이다.
Docker를 이해하는 출발점은 여기에 있다. “코드뿐 아니라, 코드를 실행하는 환경도 함께 준비해서 전달할 수 없을까?”
Git으로 같은 코드를 받았는데 왜 실행 결과가 다를까?
쇼핑몰 프로젝트를 함께 개발한다고 가정해 보자. 모두 같은 코드를 내려받았지만, 각자의 컴퓨터 상태는 다를 수 있다.
| 구분 | 개발자 A | 개발자 B |
| Java | 프로젝트에 맞는 버전 | 다른 프로젝트에서 사용하던 버전 |
| MySQL | 필요한 버전 설치 완료 | 미설치 |
| 실행 설정 | 환경 변수 설정 완료 | 일부 설정 누락 |
| 기존 프로그램 | 포트 충돌 없음 | 다른 프로그램이 같은 포트 사용 |
Git은 프로젝트 파일을 공유해 주지만, 각 컴퓨터에 설치된 프로그램과 실행 환경까지 맞춰 주지는 않는다.
Docker는 애플리케이션과 실행에 필요한 파일, 라이브러리 등을 이미지(Image) 로 묶고, 이를 컨테이너(Container) 로 실행하도록 돕는다. 덕분에 매번 환경을 수작업으로 구성하는 부담을 줄일 수 있다.
예를 들어 Spring Boot 애플리케이션의 JAR 파일과 Java 실행 환경을 이미지에 담으면, 팀원이나 배포 서버는 해당 이미지를 받아 컨테이너로 실행할 수 있다.
공유 대상이 소스 코드에서 실행 가능한 패키지로 넓어지는 것이다.
다만 같은 이미지를 사용한다고 모든 조건이 자동으로 같아지지는 않는다.
환경 변수, 연결할 DB, 저장된 데이터, CPU 아키텍처 등도 실행에 영향을 준다. Docker는 환경 차이를 줄이는 도구이지, 모든 차이를 없애는 도구는 아니다.
컴퓨터를 한 대 더 만드는 대신, 실행 공간을 나눈다
환경을 분리하는 방법으로는 가상 머신인 VM도 있다. 그렇다면 Docker 컨테이너와 무엇이 다를까?
비유하자면 VM은 각자 설비를 갖춘 집을 여러 채 만드는 방식, 컨테이너는 한 건물의 기반 시설을 공유하면서 공간을 나누는 방식에 가깝다.
VM은 가상 하드웨어 위에 게스트 운영체제를 실행한다. 각 VM이 자기 운영체제의 커널을 가진다.
반면 컨테이너는 커널을 공유하면서 프로세스와 파일 시스템 등의 실행 공간을 격리한다.
여기서 커널은 CPU, 메모리 같은 자원을 관리하는 운영체제의 핵심 부분이다.
| 비교 항목 | VM | Docker 컨테이너 |
| 비유 | 설비를 각각 갖춘 여러 집 | 기반 시설을 공유하는 분리된 공간 |
| 실행 구조 | 가상 하드웨어 위에 게스트 OS 실행 | 커널을 공유하며 프로세스 격리 |
| 운영체제 커널 | VM마다 별도 커널 | 같은 실행 기반의 커널 공유 |
| 자원 부담 | 상대적으로 큼 | 상대적으로 작음 |
| 시작 과정 | 게스트 OS 부팅 필요 | 주로 애플리케이션 프로세스 시작 |
이 차이 때문에 컨테이너는 일반적으로 VM보다 가볍고 빠르게 시작할 수 있다.
그렇다고 VM과 Docker 중 하나만 선택해야 하는 것은 아니다. 가상 머신으로 서버를 준비하고, 그 안에서 Docker 컨테이너를 실행할 수도 있다.
또한 Mac에서 Linux 컨테이너를 실행할 때는 macOS 커널을 직접 공유하는 것이 아니다. Docker Desktop이 사용하는 Linux VM 안에서 컨테이너들이 Linux 커널을 공유한다고 이해하면 된다.
같은 이미지로 실행해도 컨테이너는 서로 다르다
이미지와 컨테이너는 자주 함께 등장하지만, 역할은 다르다.
이미지는 컨테이너를 만들기 위한 읽기 전용 패키지이고, 컨테이너는 그 이미지로 만들어진 실행 인스턴스다.
컨테이너는 실행할 수도, 중지할 수도, 삭제할 수도 있다.
하나의 클래스로 여러 객체를 만들듯, 하나의 이미지로 여러 컨테이너를 만들 수 있다. (물론 구현 원리까지 같다는 뜻은 아니다.)
예를 들어 shop-api:1.0이라는 이미지가 있다고 하자.
docker run -d --name shop-api-a -p 8081:8080 shop-api:1.0
docker run -d --name shop-api-b -p 8082:8080 shop-api:1.0
같은 이미지로 shop-api-a, shop-api-b라는 두 컨테이너를 실행한 것이다.
두 컨테이너는 같은 애플리케이션으로 시작하지만, 각각 별도의 프로세스와 쓰기 가능한 저장 계층을 가진다.
한쪽 컨테이너 안에서 파일을 생성해도 다른 컨테이너에 자동으로 생기지는 않는다.
따라서 팀원들이 같은 이미지를 사용한다는 것은 같은 컨테이너 하나를 함께 쓴다는 의미가 아니다. 각자의 컴퓨터에서 같은 이미지를 바탕으로 별도의 컨테이너를 실행하는 것이다.
이미지를 다시 빌드할 때 모든 작업을 반복하지 않는 이유
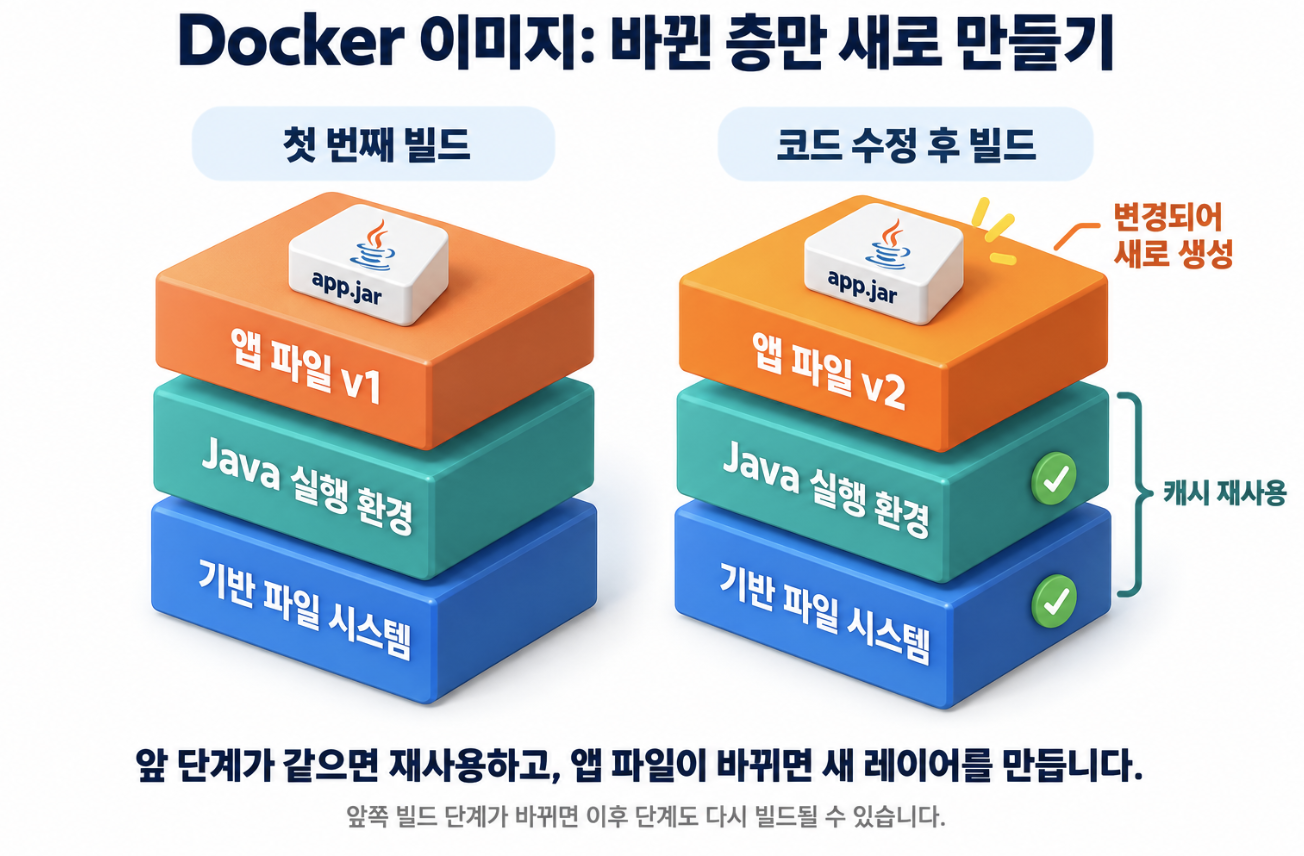
Spring Boot의 코드를 수정했다고 해서 Java 실행 환경까지 매번 새로 준비할 필요는 없다.
Docker는 이전 빌드 결과를 활용해 이런 반복 작업을 줄인다.
이를 이해하려면 이미지의 레이어(Layer) 구조를 살펴봐야 하는데 Docker 이미지는 파일 시스템의 변경 사항을 담은 여러 레이어와 실행 설정으로 구성된다. 여러 장의 투명 필름을 겹쳐 하나의 그림을 완성하듯, 레이어들이 합쳐져 애플리케이션을 실행할 파일 시스템을 만든다.
다음 Dockerfile을 예로 들어 본다면, 실행 가능한 JAR 파일을 app.jar라는 이름으로 준비했다고 가정한다.
FROM eclipse-temurin:17-jdk-alpine

WORKDIR /app

COPY app.jar app.jar

ENTRYPOINT ["java", "-jar", "app.jar"]
Docker는 위에서 아래로 지시사항을 한다.
| 명령어 | 수행하는 작업 |
| FROM | Java 실행 환경이 포함된 베이스 이미지를 바탕으로 시작 |
| WORKDIR | 이후 작업의 기준 디렉터리를 /app으로 설정 |
| COPY | 준비한 애플리케이션 파일을 이미지에 추가 |
| ENTRYPOINT | 컨테이너가 시작될 때 실행할 명령을 기록 |
여기서 Dockerfile의 한 줄이 반드시 파일 레이어 하나를 만든다는 것은 아니다.
COPY는 파일을 추가하는 반면, ENTRYPOINT는 실행 방법을 이미지 설정에 기록하고, 베이스 이미지 자체도 이미 여러 레이어로 구성되어 있을 수 있다.
이 상태에서 주문 기능을 수정하고 새로운 app.jar를 만들었다고 가정해보고 베이스 이미지와 앞선 빌드 조건이 그대로이고 유효한 캐시가 남아 있다면, Docker는 해당 단계의 결과를 재사용할 수 있다. 내용이 달라진 JAR 파일을 복사하는 단계는 다시 처리합니다.
즉, 변경되지 않은 준비 과정은 활용하고, 수정된 애플리케이션을 반영하는 작업을 수행하는 것입니다. 이것이 빌드 캐시가 시간을 줄여 주는 원리다.
다만 “전에 실행한 명령이니 무조건 재사용한다”는 뜻은 아니고 명령어와 입력 파일, 앞선 단계의 결과 등이 캐시 판단에 영향을 준다.
앞쪽 단계가 변경되면 그 결과에 의존하는 뒤쪽 단계도 다시 처리될 수 있다.
그래서 Dockerfile은 보통 변경이 드문 준비 작업을 앞에 두고, 자주 바뀌는 애플리케이션 파일을 뒤에서 추가하도록 구성합니다.
이렇게 하면 코드를 수정할 때 기존 빌드 결과를 활용할 가능성이 높아집니다.
컨테이너를 교체하면 회원과 주문 데이터도 사라질까?
애플리케이션은 새 버전으로 교체할 수 있지만, 회원과 주문 데이터는 계속 남아 있어야 한다.
컨테이너에는 쓰기 가능한 저장 계층이 있지만, 이 계층의 데이터는 해당 컨테이너를 삭제하면 함께 사라진다.
단순히 중지했다가 다시 시작하는 것과 삭제 후 새로 만드는 것은 다르다.
이처럼 컨테이너의 수명과 데이터를 분리할 때 사용하는 것이 볼륨(Volume) 이다. 볼륨은 Docker가 관리하는 별도의 저장 공간이며, 컨테이너의 특정 경로에 연결해서 사용한다.
MySQL을 예로 들면 다음 연결을 생각할 수 있다.
-v mysql-data:/var/lib/mysql
| 부분 | 의미 |
| mysql-data | Docker가 관리하는 이름 있는 볼륨 |
| /var/lib/mysql | 컨테이너 안에서 MySQL이 데이터를 저장하는 경로 |
MySQL은 컨테이너 안의 /var/lib/mysql에 데이터를 기록하지만, 해당 경로에 볼륨이 연결되어 있으므로 데이터는 볼륨에 저장된다.
이후 컨테이너를 삭제하더라도 볼륨을 남겨 두고, 호환되는 MySQL 컨테이너에 다시 연결하면 기존 데이터를 사용할 수 있다.
여기서 기억할 점은 두 가지다.
- 볼륨 자체를 삭제하면 저장된 데이터도 사라진다.
- 이미지를 공유한다고 볼륨의 데이터까지 팀원에게 전달되는 것은 아니다.
즉, 같은 MySQL 이미지로 실행해도 각자의 DB 데이터는 별개다.
공통 테스트 데이터가 필요하다면 초기화 SQL 같은 방법을 따로 준비해야 한다.
볼륨은 컨테이너 교체에 대비한 데이터 보존 수단이며, 백업을 대신하지는 않는다.
서버는 켜졌는데 왜 localhost로 접속되지 않을까?
컨테이너 안에서 애플리케이션이 실행되었다고 해서 내 컴퓨터의 같은 포트로 자동 연결되는 것은 아니다.
일반적인 Docker의 bridge 네트워크 환경에서는 컨테이너가 별도의 네트워크 공간을 사용한다. 내 컴퓨터에서 컨테이너의 서비스에 접속하려면 포트 매핑, 즉 포트 게시 설정을 할 수 있다.
docker run -d --name shop-api -p 8081:8080 shop-api:1.0-p 8081:8080은 다음 의미다.
| 구분 | 포트 | 역할 |
| 앞쪽 | 8081 | 내 컴퓨터에서 접속할 포트 |
| 뒤쪽 | 8080 | 컨테이너 안에서 애플리케이션이 사용하는 포트 |
따라서 브라우저나 API 테스트 도구에서는 localhost:8081로 접속한다. Docker가 해당 요청을 컨테이너의 8080 포트로 전달한다.
여기서 Spring Boot의 서버 포트가 8081로 바뀐 것은 아니다. 애플리케이션은 여전히 컨테이너 안의 8080 포트에서 요청을 기다린다.
Dockerfile의 EXPOSE 8080도 구분해야 한다. 이 명령어는 사용하는 포트를 명시할 뿐, 호스트에 포트를 자동으로 게시하지 않는다. 실제 접속 경로를 만들려면 -p 같은 설정이 필요하다.
같은 커널을 쓰는데 어떻게 독립된 공간이 될까?
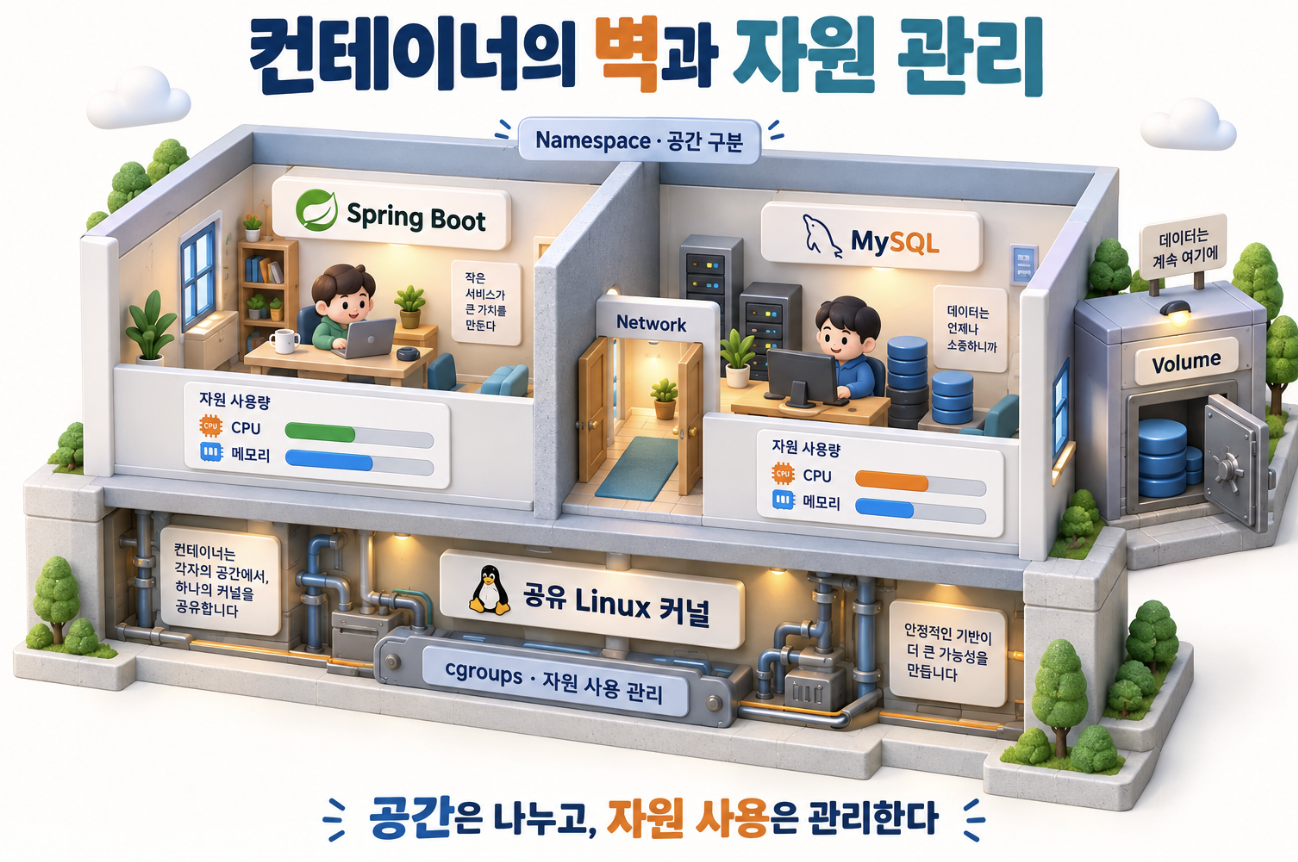
컨테이너는 운영체제의 커널을 공유한다. 커널이 CPU와 메모리 같은 자원을 관리하는 ‘건물 관리실’이라면, 여러 컨테이너가 하나의 관리실을 이용하는 셈이다.
그런데 관리실을 공유한다고 해서 모든 입주자가 다른 방 안을 자유롭게 들여다보거나, 건물의 전기를 무제한으로 사용해도 되는 것은 아니다. 각 공간을 구분하는 장치와 자원 사용을 관리하는 장치가 필요하다.
Linux 컨테이너에서는 이 역할을 담당하는 대표적인 기술이 Namespace와 cgroups다.
Namespace는 ‘내가 볼 수 있는 범위’를 나눈다
Namespace는 프로세스가 바라보는 시스템 자원의 범위를 구분하는 Linux 커널 기능이다.
쉽게 말해, 같은 컴퓨터에서 실행되는 프로그램들에게 서로 다른 공간을 보여 주는 것이다.
예를 들어 Spring Boot 컨테이너와 MySQL 컨테이너를 실행했다고 생각하면, 일반적인 격리 설정에서는 Spring Boot 컨테이너 안에서 프로세스 목록을 조회해도 MySQL 컨테이너의 프로세스가 보이지 않는다. 같은 컴퓨터에서 실행되고 있지만, 볼 수 있는 프로세스 범위가 나뉘어 있기 때문이다.
네트워크도 비슷하다. 각 컨테이너가 별도의 네트워크 공간을 사용하므로, 두 컨테이너 안에서 각각 8080번 포트를 사용할 수 있다. 단, 이를 호스트에 게시할 때 같은 호스트 IP의 같은 포트를 동시에 차지할 수는 없다.
| 구분하는 대상 | 컨테이너에서 보이는 모습 |
| 프로세스 | 자기 공간의 프로세스만 보임 |
| 네트워크 | 자기 네트워크 인터페이스와 포트 공간을 사용함 |
| 마운트 | 자기 공간에 연결된 파일 시스템을 봄 |
| 호스트 이름 | 자기 호스트 이름을 가질 수 있음 |
파일 시스템의 경우에는 마운트 Namespace뿐 아니라 이미지의 파일 시스템과 컨테이너의 루트 디렉터리 설정 등이 함께 작동한다. 이 구성을 통해 각 컨테이너는 자기만의 파일 공간을 가진 것처럼 동작한다.
컨테이너 안에서 보이지 않는다고 실제로 존재하지 않는 것은 아니다. 호스트에서는 컨테이너의 프로세스를 확인할 수 있다. Namespace는 새로운 컴퓨터를 만드는 것이 아니라, 프로세스가 보는 범위를 나누는 기술이다.
cgroups는 ‘얼마나 사용할 수 있는지’를 관리한다
공간을 나누는 것만으로 자원 사용 문제까지 해결되지는 않는다. 옆방이 보이지 않더라도 한 입주자가 건물의 전력을 지나치게 사용하면 다른 입주자에게 영향을 줄 수 있다.
컨테이너도 마찬가지다. Spring Boot 컨테이너가 CPU나 메모리를 과도하게 사용하면 같은 서버의 MySQL 컨테이너도 영향을 받을 수 있다.
cgroups는 프로세스들을 그룹으로 묶어 CPU, 메모리 같은 자원의 사용량을 관리하고 제한하는 Linux 커널 기능이다. 비유하자면 방마다 사용량을 측정하는 계량기와 한도를 제어하는 장치를 설치하는 것이다.
Docker에서는 다음처럼 자원 한도를 지정할 수 있다.
docker run -d \
  --name shop-api \
  --memory=512m \
  --cpus=1 \
  shop-api:1.0
| 설정 | 의미 |
| --memory=512m | 컨테이너의 메모리 한도를 512MiB로 설정 |
| --cpus=1 | CPU 사용 시간을 CPU 1개 분량으로 제한 |
--cpus=1은 특정 CPU 코어 하나를 전용으로 배정한다는 의미는 아니다. 여러 코어에서 실행되더라도 사용할 수 있는 CPU 시간의 총량을 제한하는 방식이다.
또한 Docker로 실행했다는 이유만으로 컨테이너마다 적절한 자원 한도가 자동으로 정해지는 것은 아니다. 필요한 제한을 설정해야 특정 컨테이너의 과도한 자원 사용을 제어할 수 있다.