상황
회원가입 로직은 비교적 간단하다고 생각이 들어서 후순위로 밀리기 쉬운 코드다.
로그인, 비밀번호 찾기에 비하면 화려할 것도 없고, 이메일 형식과 비밀번호 길이 정도만 확인하면 끝이라고 생각하기 쉽다.
그런데 비밀번호 필드 하나를 조금만 파고들면, 프레임워크 내부 동작과 실제 CVE까지 이어지는 이야기가 나온다는 사실을 알게 되었다.
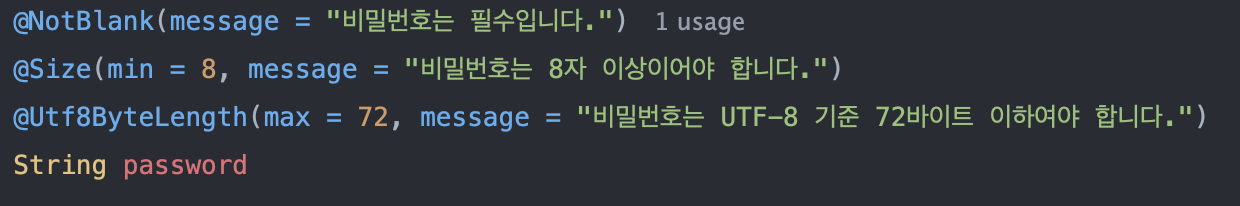
세 번째 줄, @Utf8ByteLength(max = 72)가 이 글의 주제이다.
처음 봤을 땐 "회원가입 하나에 커스텀 어노테이션까지 굳이"라는 생각이 들기도 했지만... 파고들수록, 과한 설계가 아니라 정확히 필요한 만큼의 설계라는 생각이 들었다.
72바이트라는 숫자의 정체는?
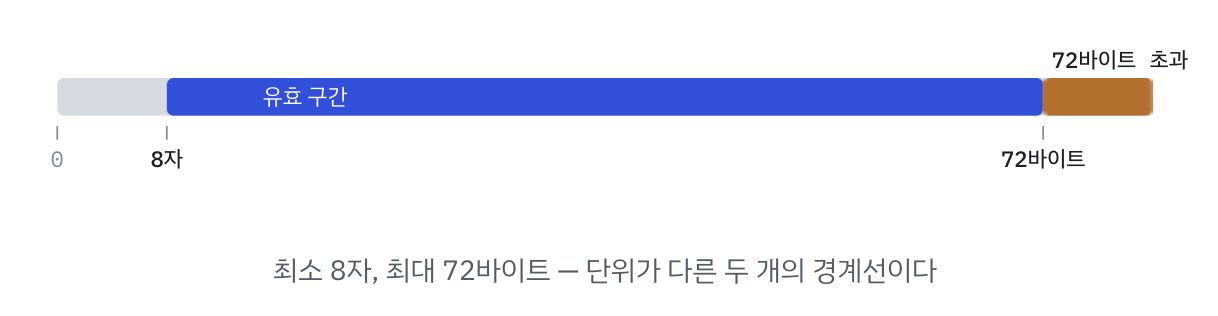
72는 임의로 정한 값이 아니다.
비밀번호 해싱에 흔히 쓰이는 BCrypt 알고리즘 자체가 입력을 72바이트까지만 처리하도록 설계되어 있다.
이 한계를 넘는 입력이 들어오면, 구현에 따라 초과분이 무시되거나 예외가 발생한다.
문제는 이 제약이 글자 수가 아니라 바이트 수 기준이라는 데 있다.
영어 알파벳은 UTF-8에서 1바이트지만, 한글은 3바이트, 이모지는 4바이트를 차지한다. 한글 비밀번호라면 24글자만 넘어가도 이미 72바이트를 초과할 수 있다.
여기서 @Size(max = 72)처럼 글자 수 기준 검증을 쓴다면, 72글자 이하라는 조건은 통과시키지만 그 72글자가 전부 한글이면 실제로는 216바이트짜리 입력이 BCrypt로 넘어간다. 검증은 통과했는데 아무것도 막지 못한 셈이다.
이 문제는 Spring Security도 겪었다
이론적인 우려에 그치지 않는다는 근거가 있다.
Spring Security의 BCryptPasswordEncoder는 72바이트를 초과하는 비밀번호가 들어오면 예외를 던지도록 하는 수정을 CVE-2025-22228을 통해 거쳤고, 실제로 이 예외 때문에 로그인이 실패하던 사례가 커뮤니티에 보고되었다는 사실을 알게 되었다.
이 수정을 진행하던 중, 처음 작성된 테스트는 72바이트 제한을 검증한다면서 정작 글자 수 기준으로 문자열을 만들고 있었다.
한 기여자가 'ñ' 같은 문자는 UTF-8에서 2바이트를 차지하므로, 72 글자짜리 문자열에 이런 문자가 섞이면 글자 수는 통과해도 실제 바이트 수는 72를 넘어설 수 있다고 지적했고, 결국 테스트는 바이트 기준으로 다시 작성되었다고 한다.
프레임워크를 만드는 사람들조차 처음엔 글자 수와 바이트 수를 혼동했다는 사실은, 이 구분이 결코 사소한 디테일이 아니라는 걸 보여준다.
검증 없이 방치하면 벌어지는 일
이 검증을 DTO에 넣지 않았다면, Spring Security 버전에 따라 두 가지 갈래로 나뉜다.
- 구버전을 쓰는 경우: 72바이트를 넘는 비밀번호가 조용히 잘려서 해싱된다. 앞부분 72바이트만 같은 서로 다른 두 비밀번호가 동일한 해시값을 갖게 되는, 보안상 심각한 문제로 이어질 수 있다.
- CVE 수정 이후 버전을 쓰는 경우: encode() 호출부에서 IllegalArgumentException이 그대로 발생한다. 전역 예외 핸들러가 없다면 사용자는 원인도 모른 채 500 에러를 보게 된다.
DTO 단계에서 @Utf8ByteLength로 미리 걸러내면 두 경우 모두 피할 수 있다. 잘못된 입력은 서비스 로직까지 도달하지 못하고, 400 응답과 함께 명확한 한글 메시지가 내려간다.
최소 길이는 글자 수, 최대 길이는 바이트 수
이 필드에서 눈여겨볼 지점이 하나 더 있다. 최소 길이와 최대 길이의 검증 기준을 서로 다르게 가져갔다는 점이다.
- @Size(min = 8) — 글자 수. 비밀번호 최소 길이는 사용자가 체감하는 글자 수가 기준이어야 한다. 브루트포스 난이도를 높이는 목적이라면 바이트가 아니라 글자 단위로 판단해야 의미가 있다.
- @Utf8ByteLength(max = 72) — 바이트 수. 이건 BCrypt라는 알고리즘의 물리적 한계다. 바이트 단위가 아니면 애초에 검증의 의미가 없다.
서로 다른 목적에 서로 다른 단위를 쓴 것은 실수가 아니라 의도된 설계다.
"브루트포스(brute-force)"는 무차별 대입 공격이다. 공격자가 비밀번호를 추측이 아니라 가능한 모든 조합을 하나씩 다 넣어보는 방식으로 뚫으려는 걸 말한다. "난이도"는 그 모든 조합을 다 시도하는 데 얼마나 오래 걸리는지, 즉 공격자 입장에서 얼마나 힘든 일인지를 뜻한다.
구현할 때 놓치기 쉬운 부분
- 바이트 수를 셀 때는 str.getBytes(StandardCharsets.UTF_8).length처럼 문자셋을 명시해야 한다.
인코딩을 지정하지 않으면 서버의 기본 인코딩에 따라 결과가 달라질 수 있다. - null 입력에는 통과(true)를 반환하는 것이 관례다.
null 체크는 @NotBlank의 역할로 남겨두고, 각 제약조건은 자기 책임만 지는 것이 Bean Validation의 설계 원칙이다.
마무리
회원가입 폼 하나에 커스텀 어노테이션까지 만드는 게 과해 보이기도 했지만, 이 경우는 프레임워크가 내부적으로 어떻게 동작하는지, 그 동작이 실제로 어떤 보안 문제와 연결되어 있는지를 정확히 이해하고 작성해 본 코드였다.
동일한 기능을 매번 같은 수준에서만 작성하는 것이 아니라 더 심도있게 다루어 본 경험이 된 거 같아서 의미 있는 시간이었다.
'개발일지 > CommerceBackend' 카테고리의 다른 글
| [Design]리프레시 토큰: 로테이션과 재사용 탐지를 선택한 이유 (0) | 2026.09.23 |
|---|