기존 구조의 한계
지금까지 배운 내용으로 기반으로 한 서버는 다음과 같은 구조였다.
사용자 요청 → 서버 → DB/Redis 저장 / 조회이 구조는 평소에는 문제가 없지만, 트래픽이 갑자기 증가하면 세 가지 문제가 동시에 터진다.
- 서버는 모든 요청을 "즉시" 처리해야 한다.
요청량이 갑자기 증가해도 서버는 쉬지 않고 모든 요청을 즉시 처리해야 한다. 서버가 감당할 수 있는 범위를 넘어서면 장애로 이어진다. - DB와 Redis는 동시에 많은 요청을 처리하지 못한다.
트래픽 폭증은 다음과 같은 상황에서 자주 발생한다.
- 대규모 세일 오픈
- 인기 상품 재입고
- 쇼핑몰 메인 배너 클릭 급증
- 사용자 행동 데이터는 매우 빠르게 쌓인다.
페이지 조회, 상품 클릭, 장바구니 추가, 구매, 스크롤 등 사용자 행동 로그는 실시간으로 쌓인다. 이 모든 데이터를 서버가 즉시 처리하는 방식은 부담이 클 수밖에 없다.
Kafka는 이 문제를 어떻게 해결하나
Kafka는 폭주하는 요청을 잠시 쌓아두는 큰 통, 즉 버퍼 역할을 한다.
"요청은 일단 Kafka에 넣고 끝내고, 무거운 작업은 나중에 천천히 처리한다"는 방식이다.
이 방식을 쓰면 서버는 갑작스러운 트래픽 폭증에도 죽지 않는다.
Kafka가 해결하는 핵심 문제는 세 가지다.
해결 1) 버퍼 역할 → API 서버가 죽지 않는다
Kafka가 없는 경우 서버가 모든 요청을 바로 처리해야 하므로 트래픽이 증가하면 빠르게 한계에 도달한다.
사용자 요청 → 서버 → DB/Redis 저장 / 조회Kafka가 있는 경우는 아래처럼 두 단계로 나뉜다.
Step 1. 요청 받음 → Kafka에 보내고 바로 끝냄 → 응답 빠름
Step 2. 처리할 준비가 됨 → Kafka에 있는 요청 꺼냄 → 요청 처리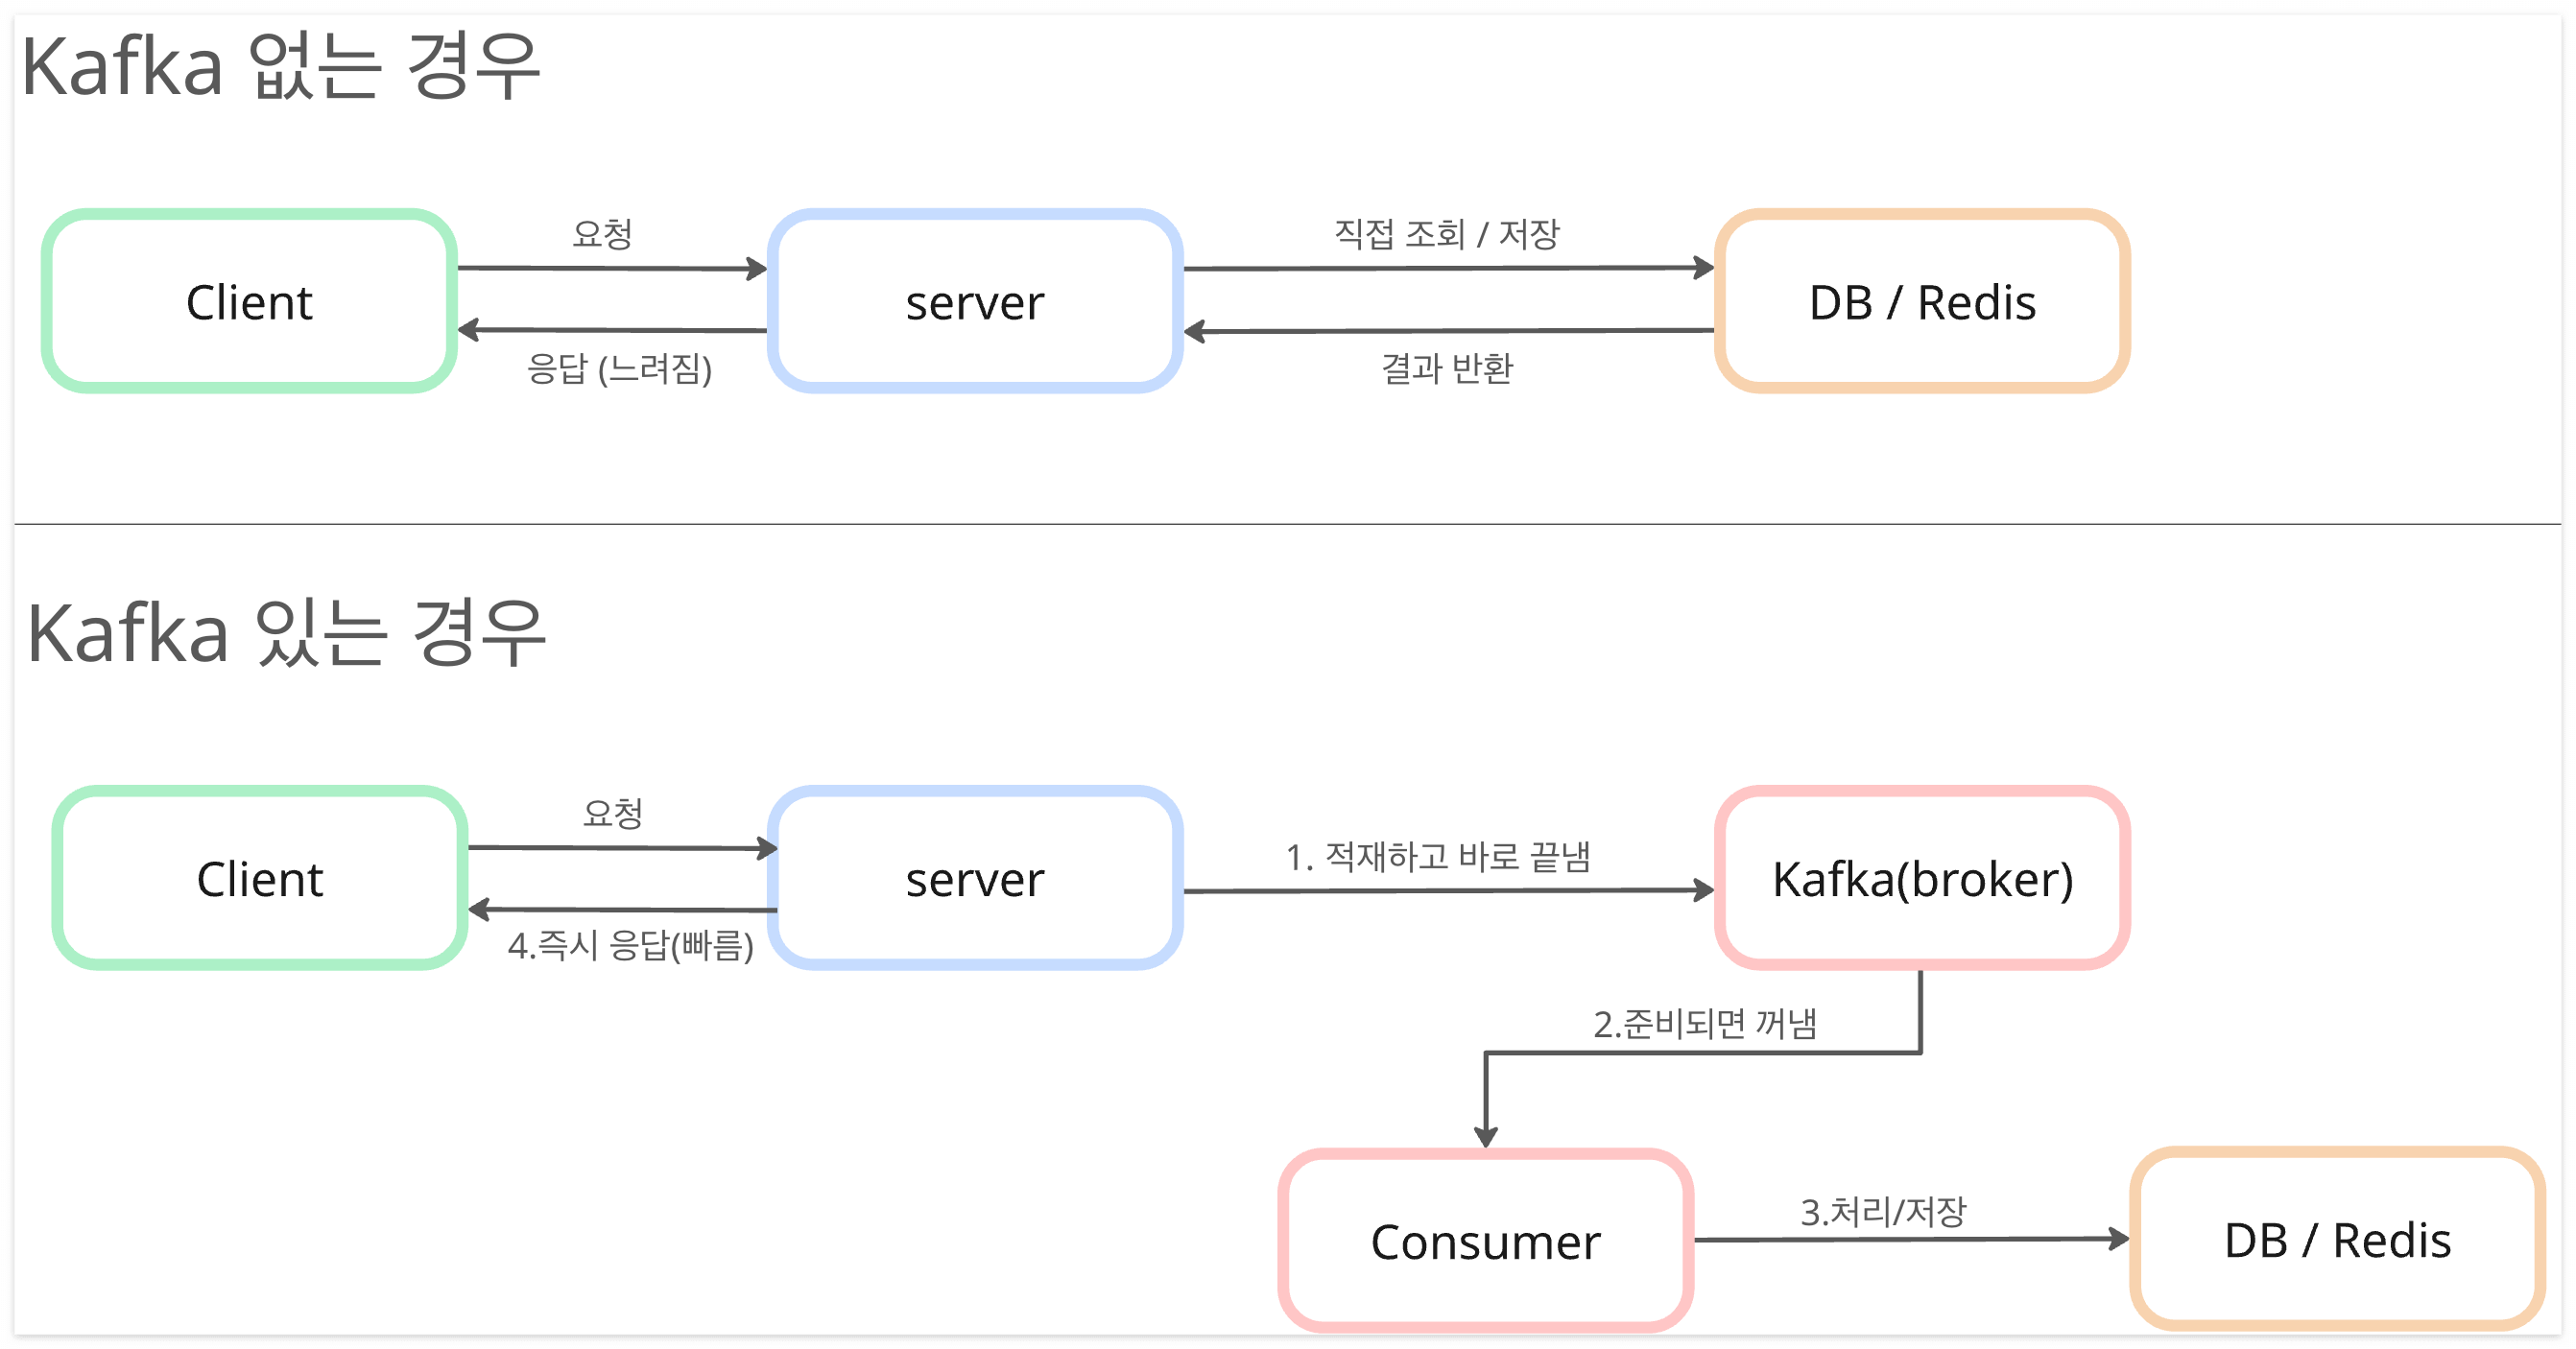
실제 이벤트 처리는 나중에 Consumer가 담당한다. API 서버는 무거운 일을 직접 하지 않기 때문에 트래픽이 10배 몰려도 버틸 수 있다.
해결 2) 비동기 처리 → 천천히, 안정적으로 처리할 수 있다
Kafka가 이벤트를 저장해두고 있기 때문에 Redis가 잠시 느려지거나, DB가 잠깐 막히거나, 서버가 재배포되는 상황에서도 이벤트는 Kafka에 그대로 남아 있다. Consumer는 이후 다시 읽어서 처리하면 되므로 데이터 유실이 없다.
Kafka는 메시지가 안전하게 처리되었다고 확인되어야 다음 메시지를 읽는다.
처리된 메시지는 즉시 삭제되지 않고, 설정된 보관 기간(retention)에 따라 삭제된다.
해결 3) 파티션 기반 병렬 처리 → 처리량이 폭발적으로 늘어난다
Kafka는 Partition이라는 병렬 처리 단위를 제공한다. 메시지를 파티션 단위로 나누어 저장하고, 각 파티션을 여러 Consumer가 병렬로 처리하게 만든다.
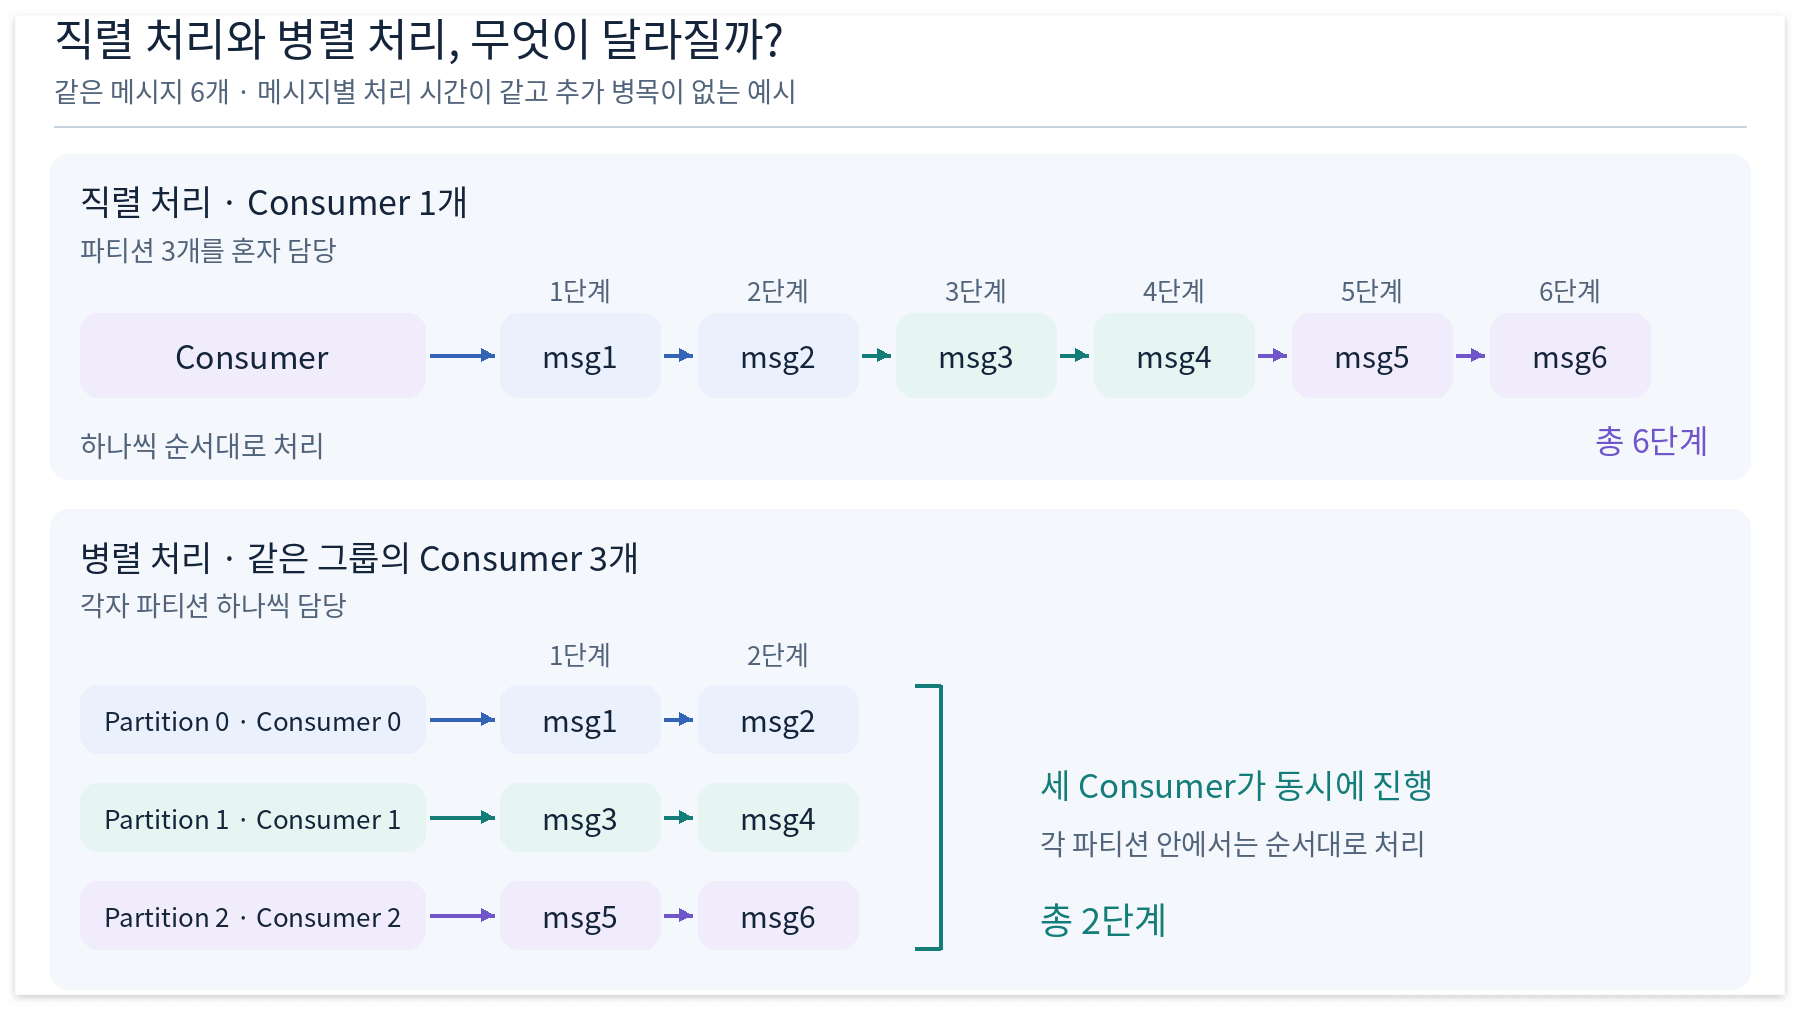
Kafka는 메시지를 안전하게 축적하고, Consumer들이 이를 병렬로 나누어 빠르게 처리할 수 있게 한다. 대규모 서비스를 운영하기 위한 핵심 기술인 셈이다.
Kafka는 결국 무엇인가 — 이벤트를 보관하는 창고
Kafka는 쉽게 말해 이벤트를 순서대로 저장해두는 큰 창고다.
- API 서버는 발생한 이벤트를 Kafka에 넣기만 한다.
- Kafka는 들어온 모든 메시지를 순서대로 차곡차곡 저장한다.
- Consumer는 저장된 메시지를 하나씩 꺼내어 처리한다.
즉 Kafka는 이벤트를 실시간으로 바로 처리하지 않아도 되게 해주는 중간 저장소다.
Kafka는 서버가 과부하 없이 이벤트를 안정적으로 처리할 수 있게 만들어주는 핵심 시스템이다.
Kafka의 핵심 구성 요소
1. 메시지(Message) — 주고받는 데이터
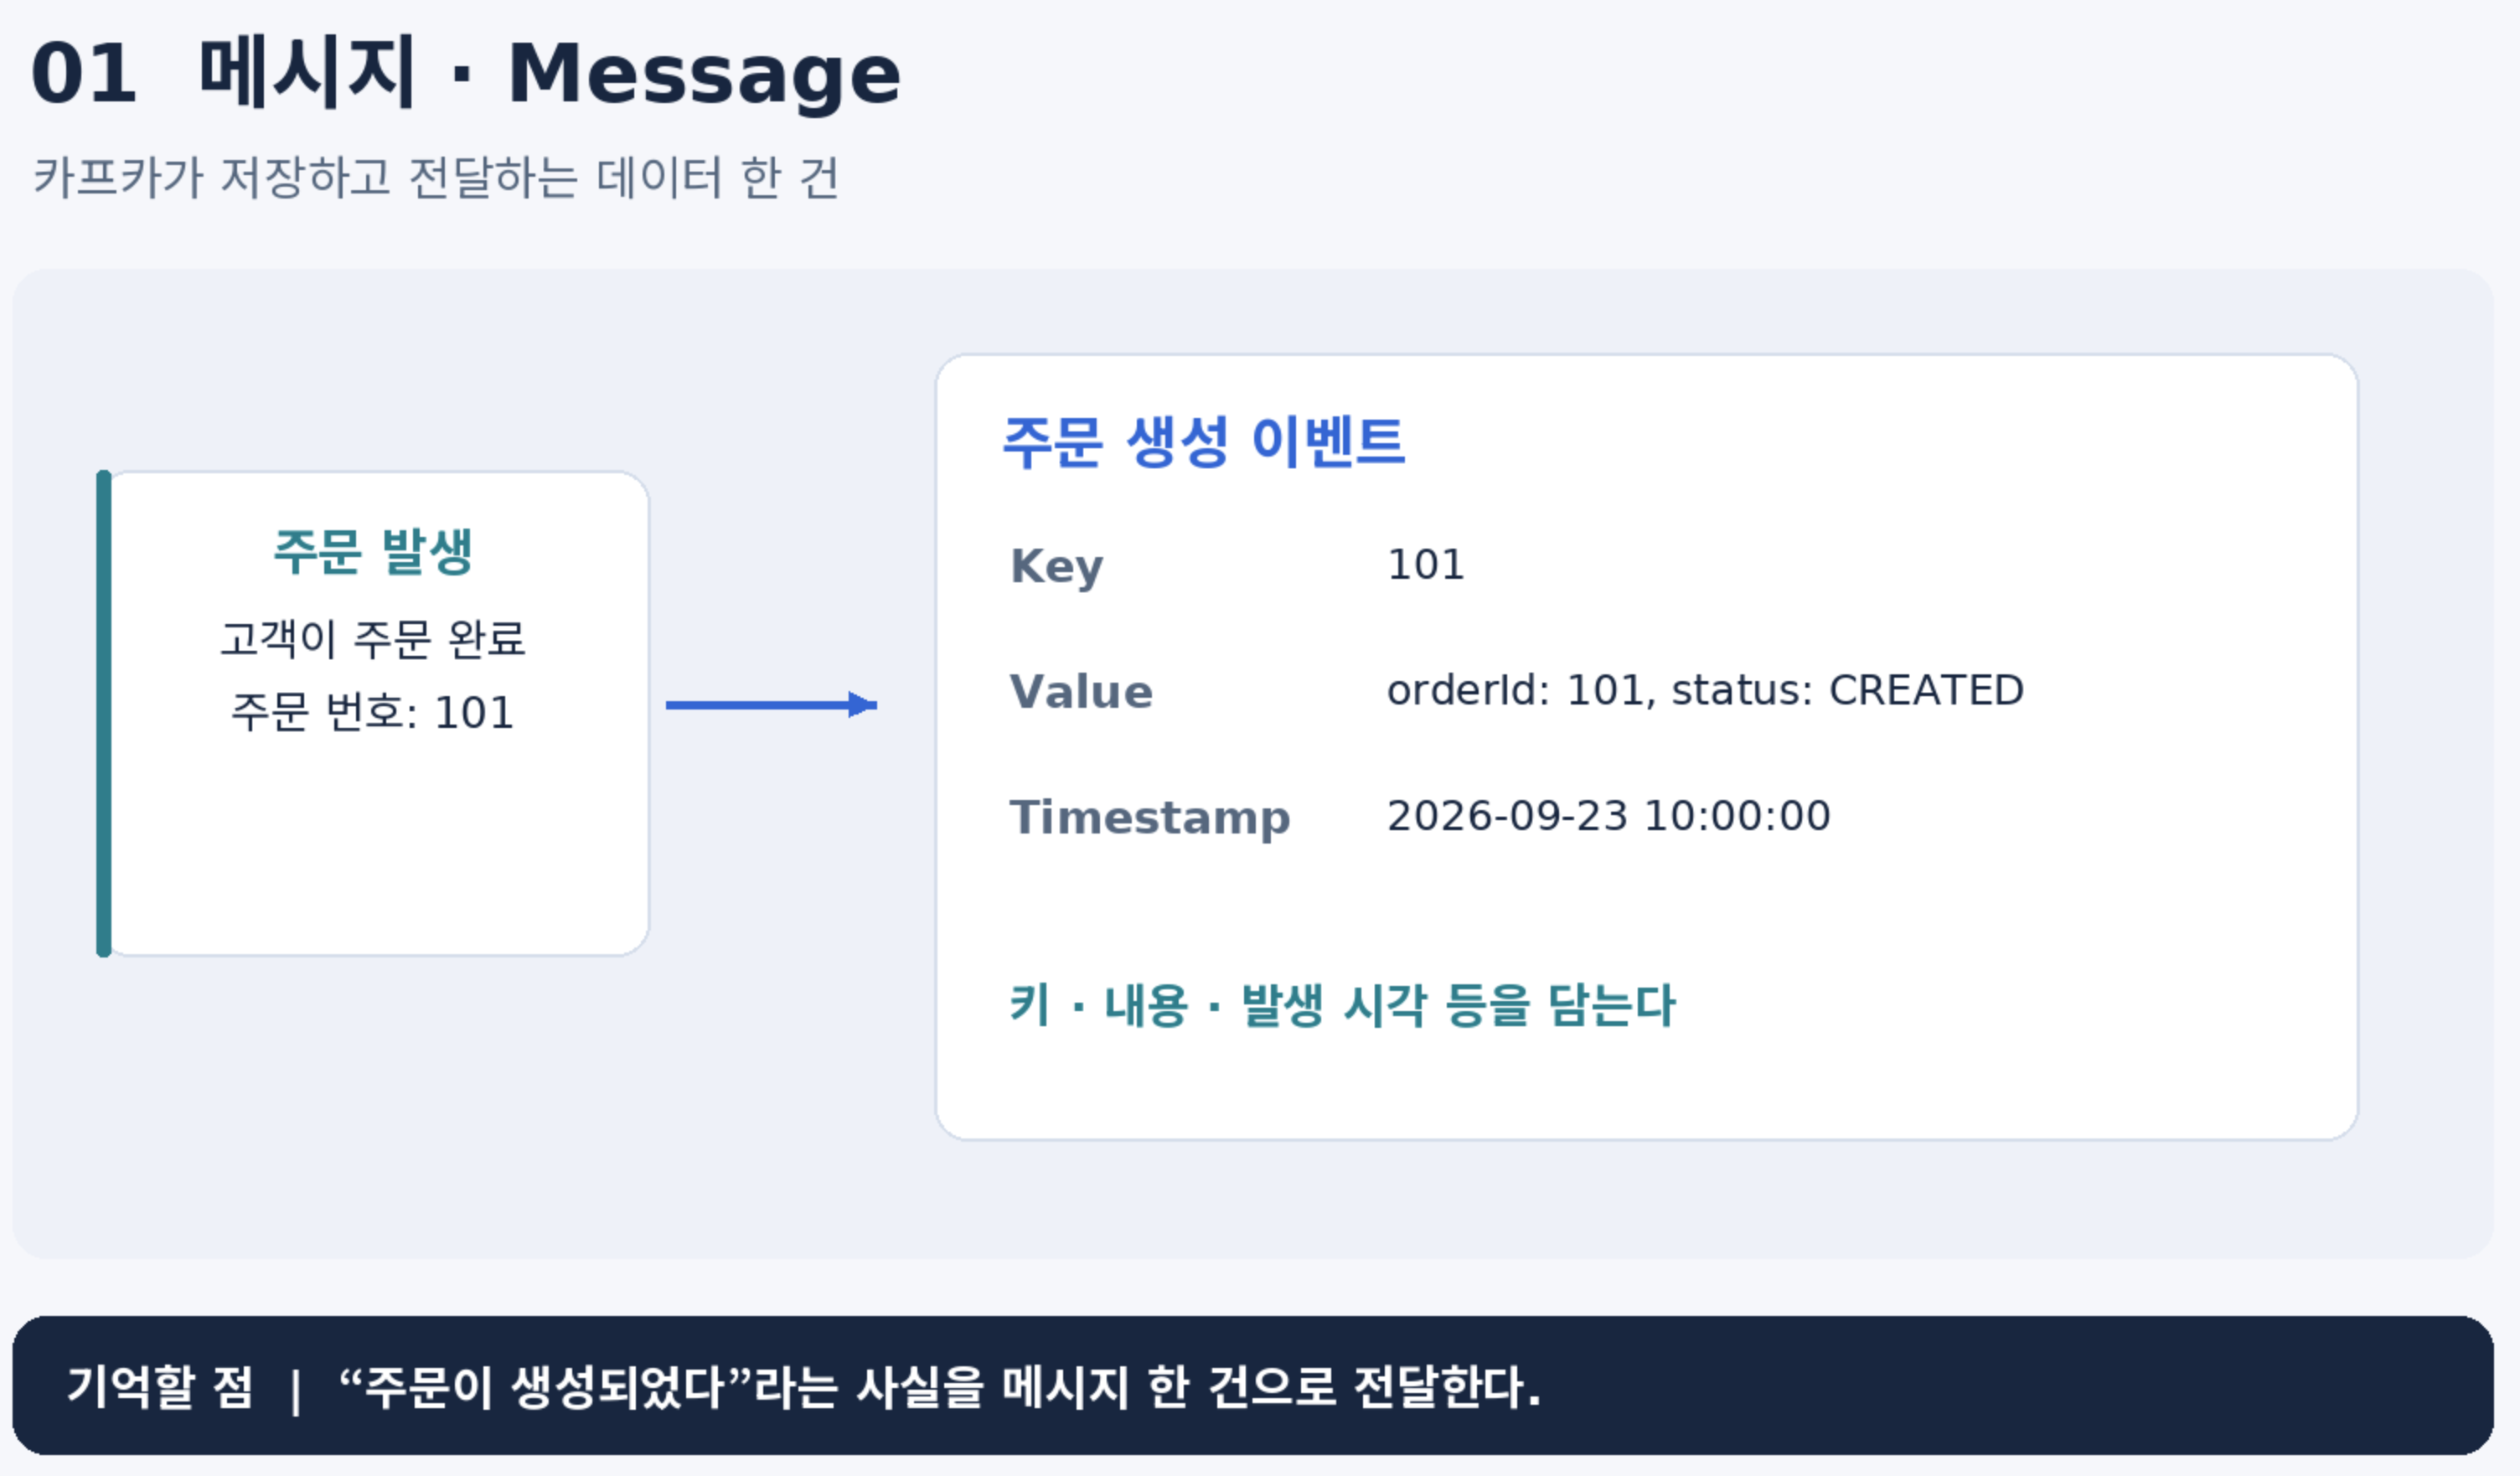
- 카프카에 저장하는 데이터 한 건이다.
- 레코드(Record)나 이벤트(Event)라고도 부른다.
- 예를 들어 “101번 주문이 생성되었다”라는 정보가 하나의 메시지가 된다. 메시지에는 실제 내용인 값(Value)과, 파티션을 결정하는 데 활용할 수 있는 키(Key) 등이 포함된다.
2. 프로듀서(Producer) — 메시지를 보내는 역할
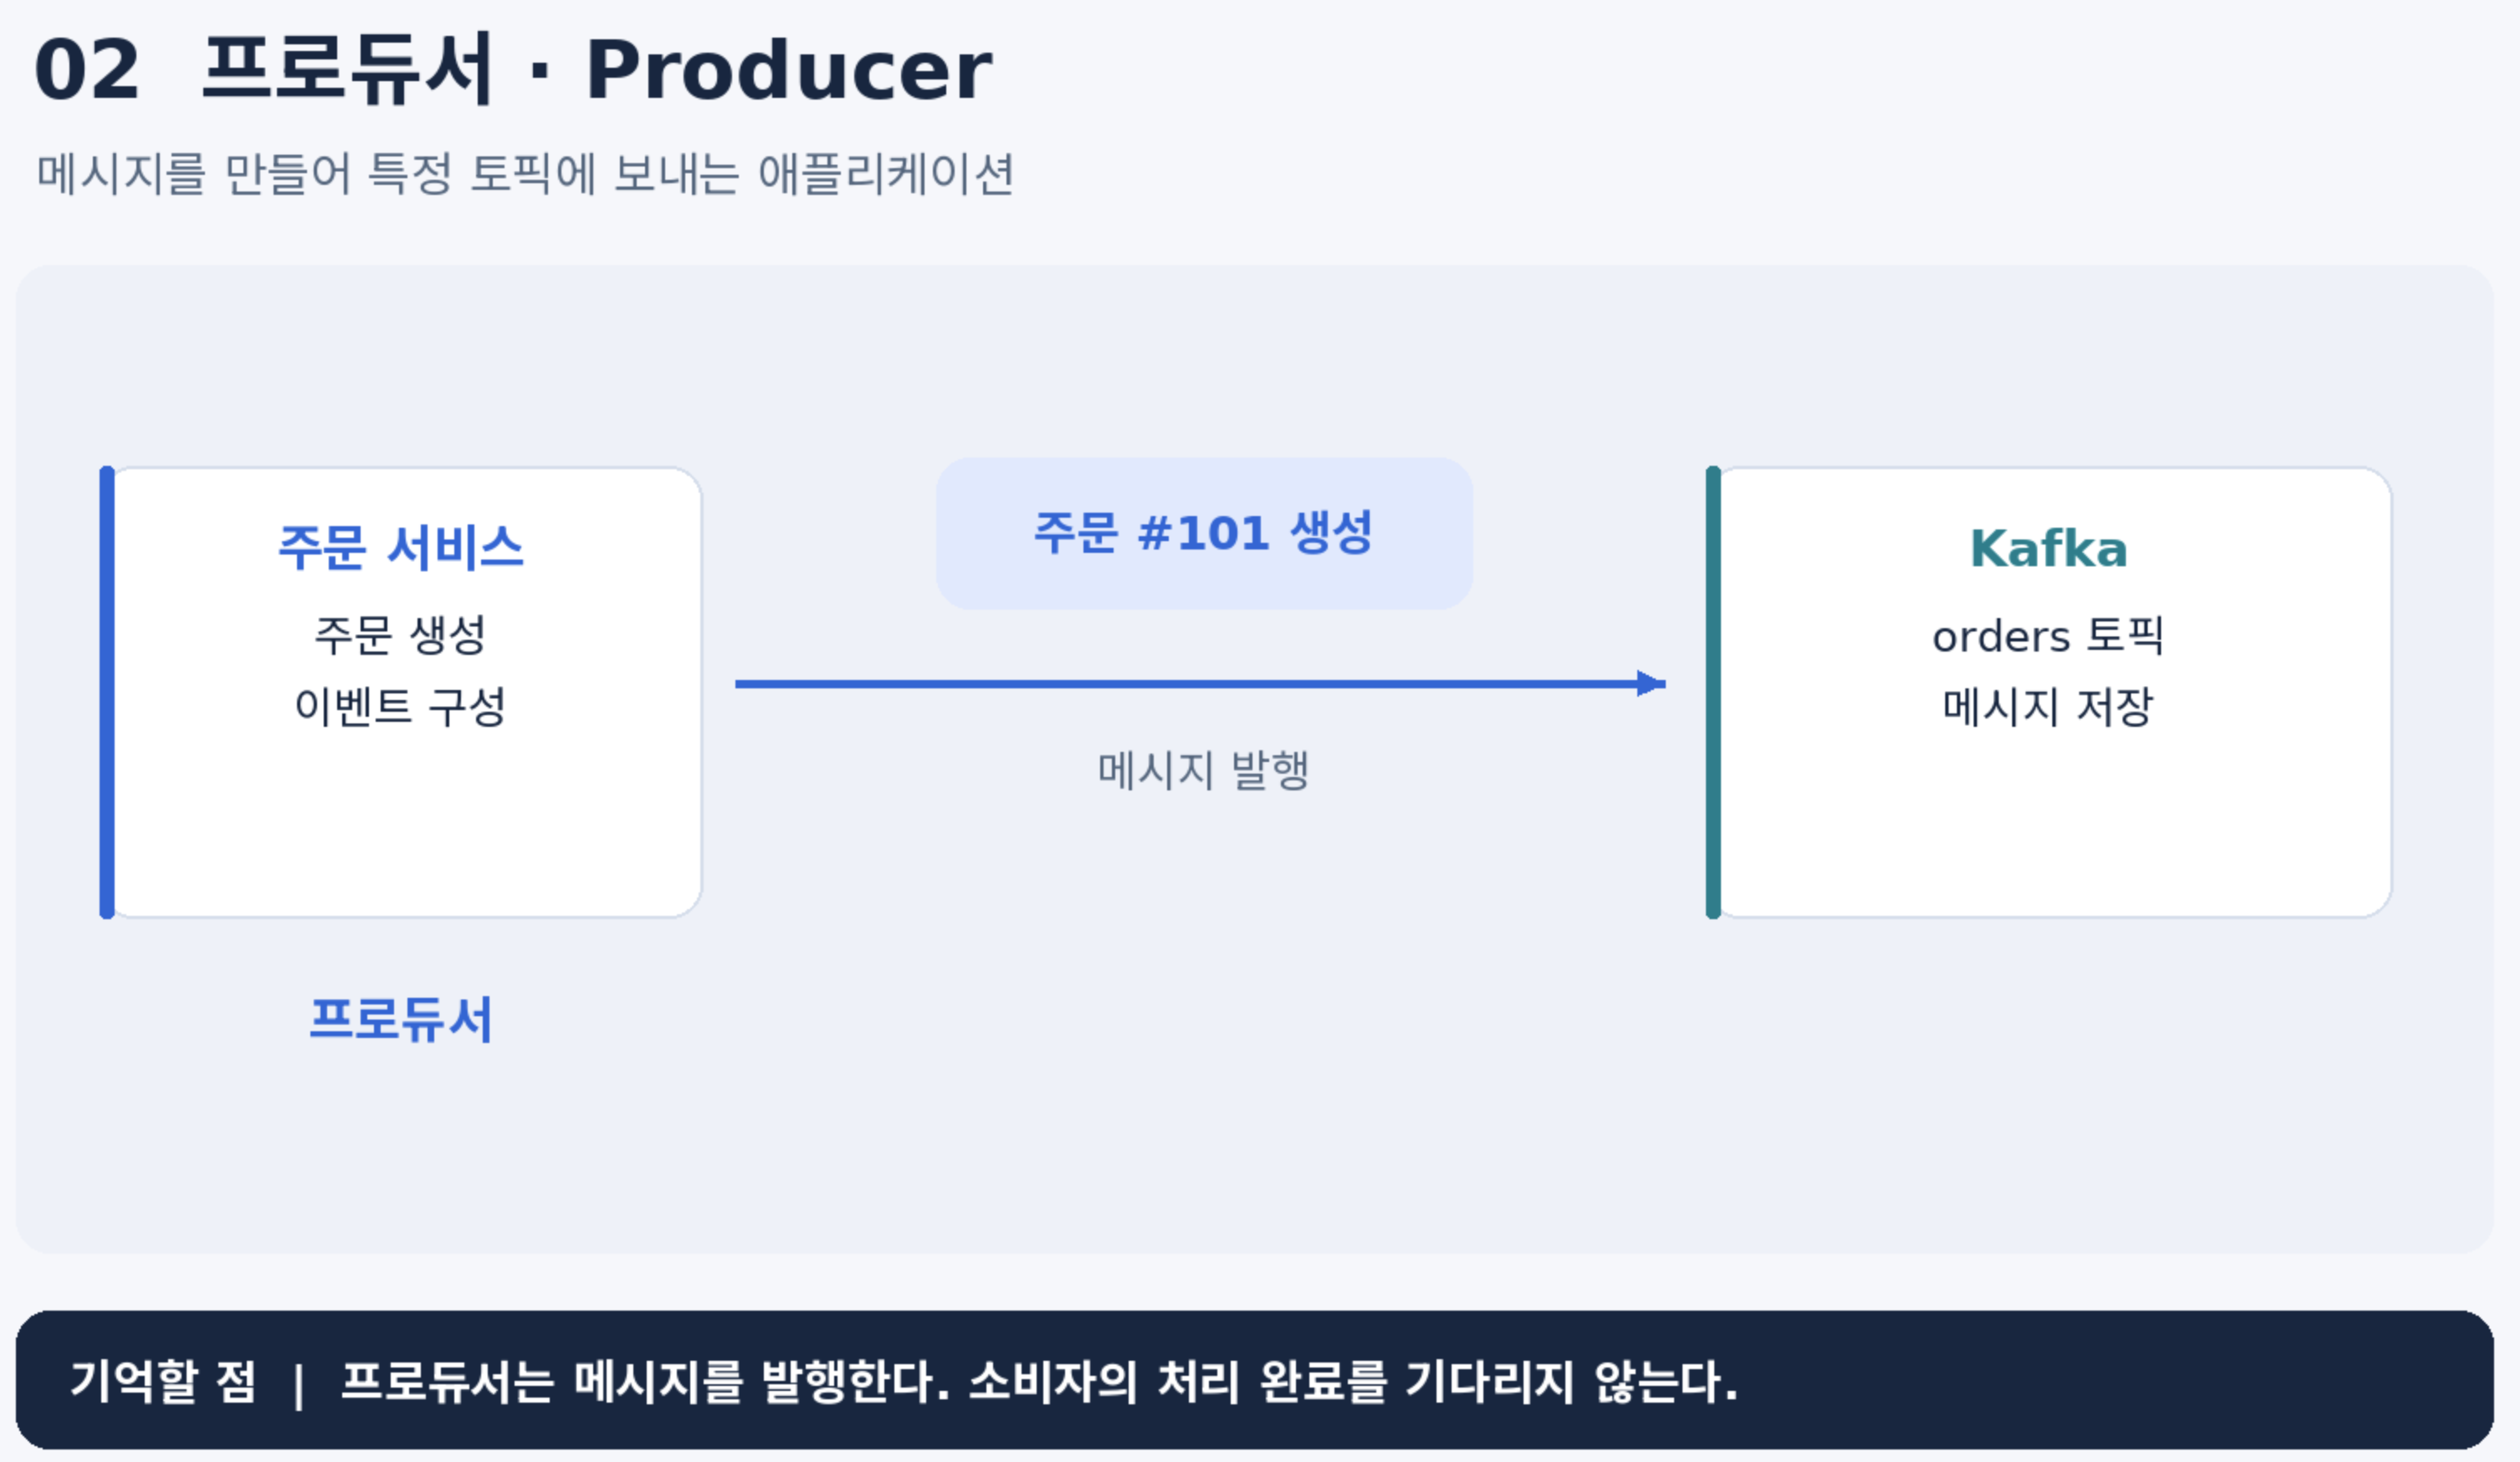
- 카프카에 메시지를 발행하는 애플리케이션이다.
- API 서버가 Producer 역할을 한다.
ex) 카테고리 클릭 이벤트 전송, 장바구니 추가 이벤트 전송
3. 컨슈머(Consumer) — 메시지를 읽는 역할

- 카프카에서 메시지를 가져와 처리하는 애플리케이션이다.
- 알림 서비스는 주문 이벤트를 읽어 알림을 보내고, 통계 서비스는 같은 이벤트를 읽어 주문 건수를 집계한다.
4. 토픽(Topic) — 메시지를 구분하는 이름
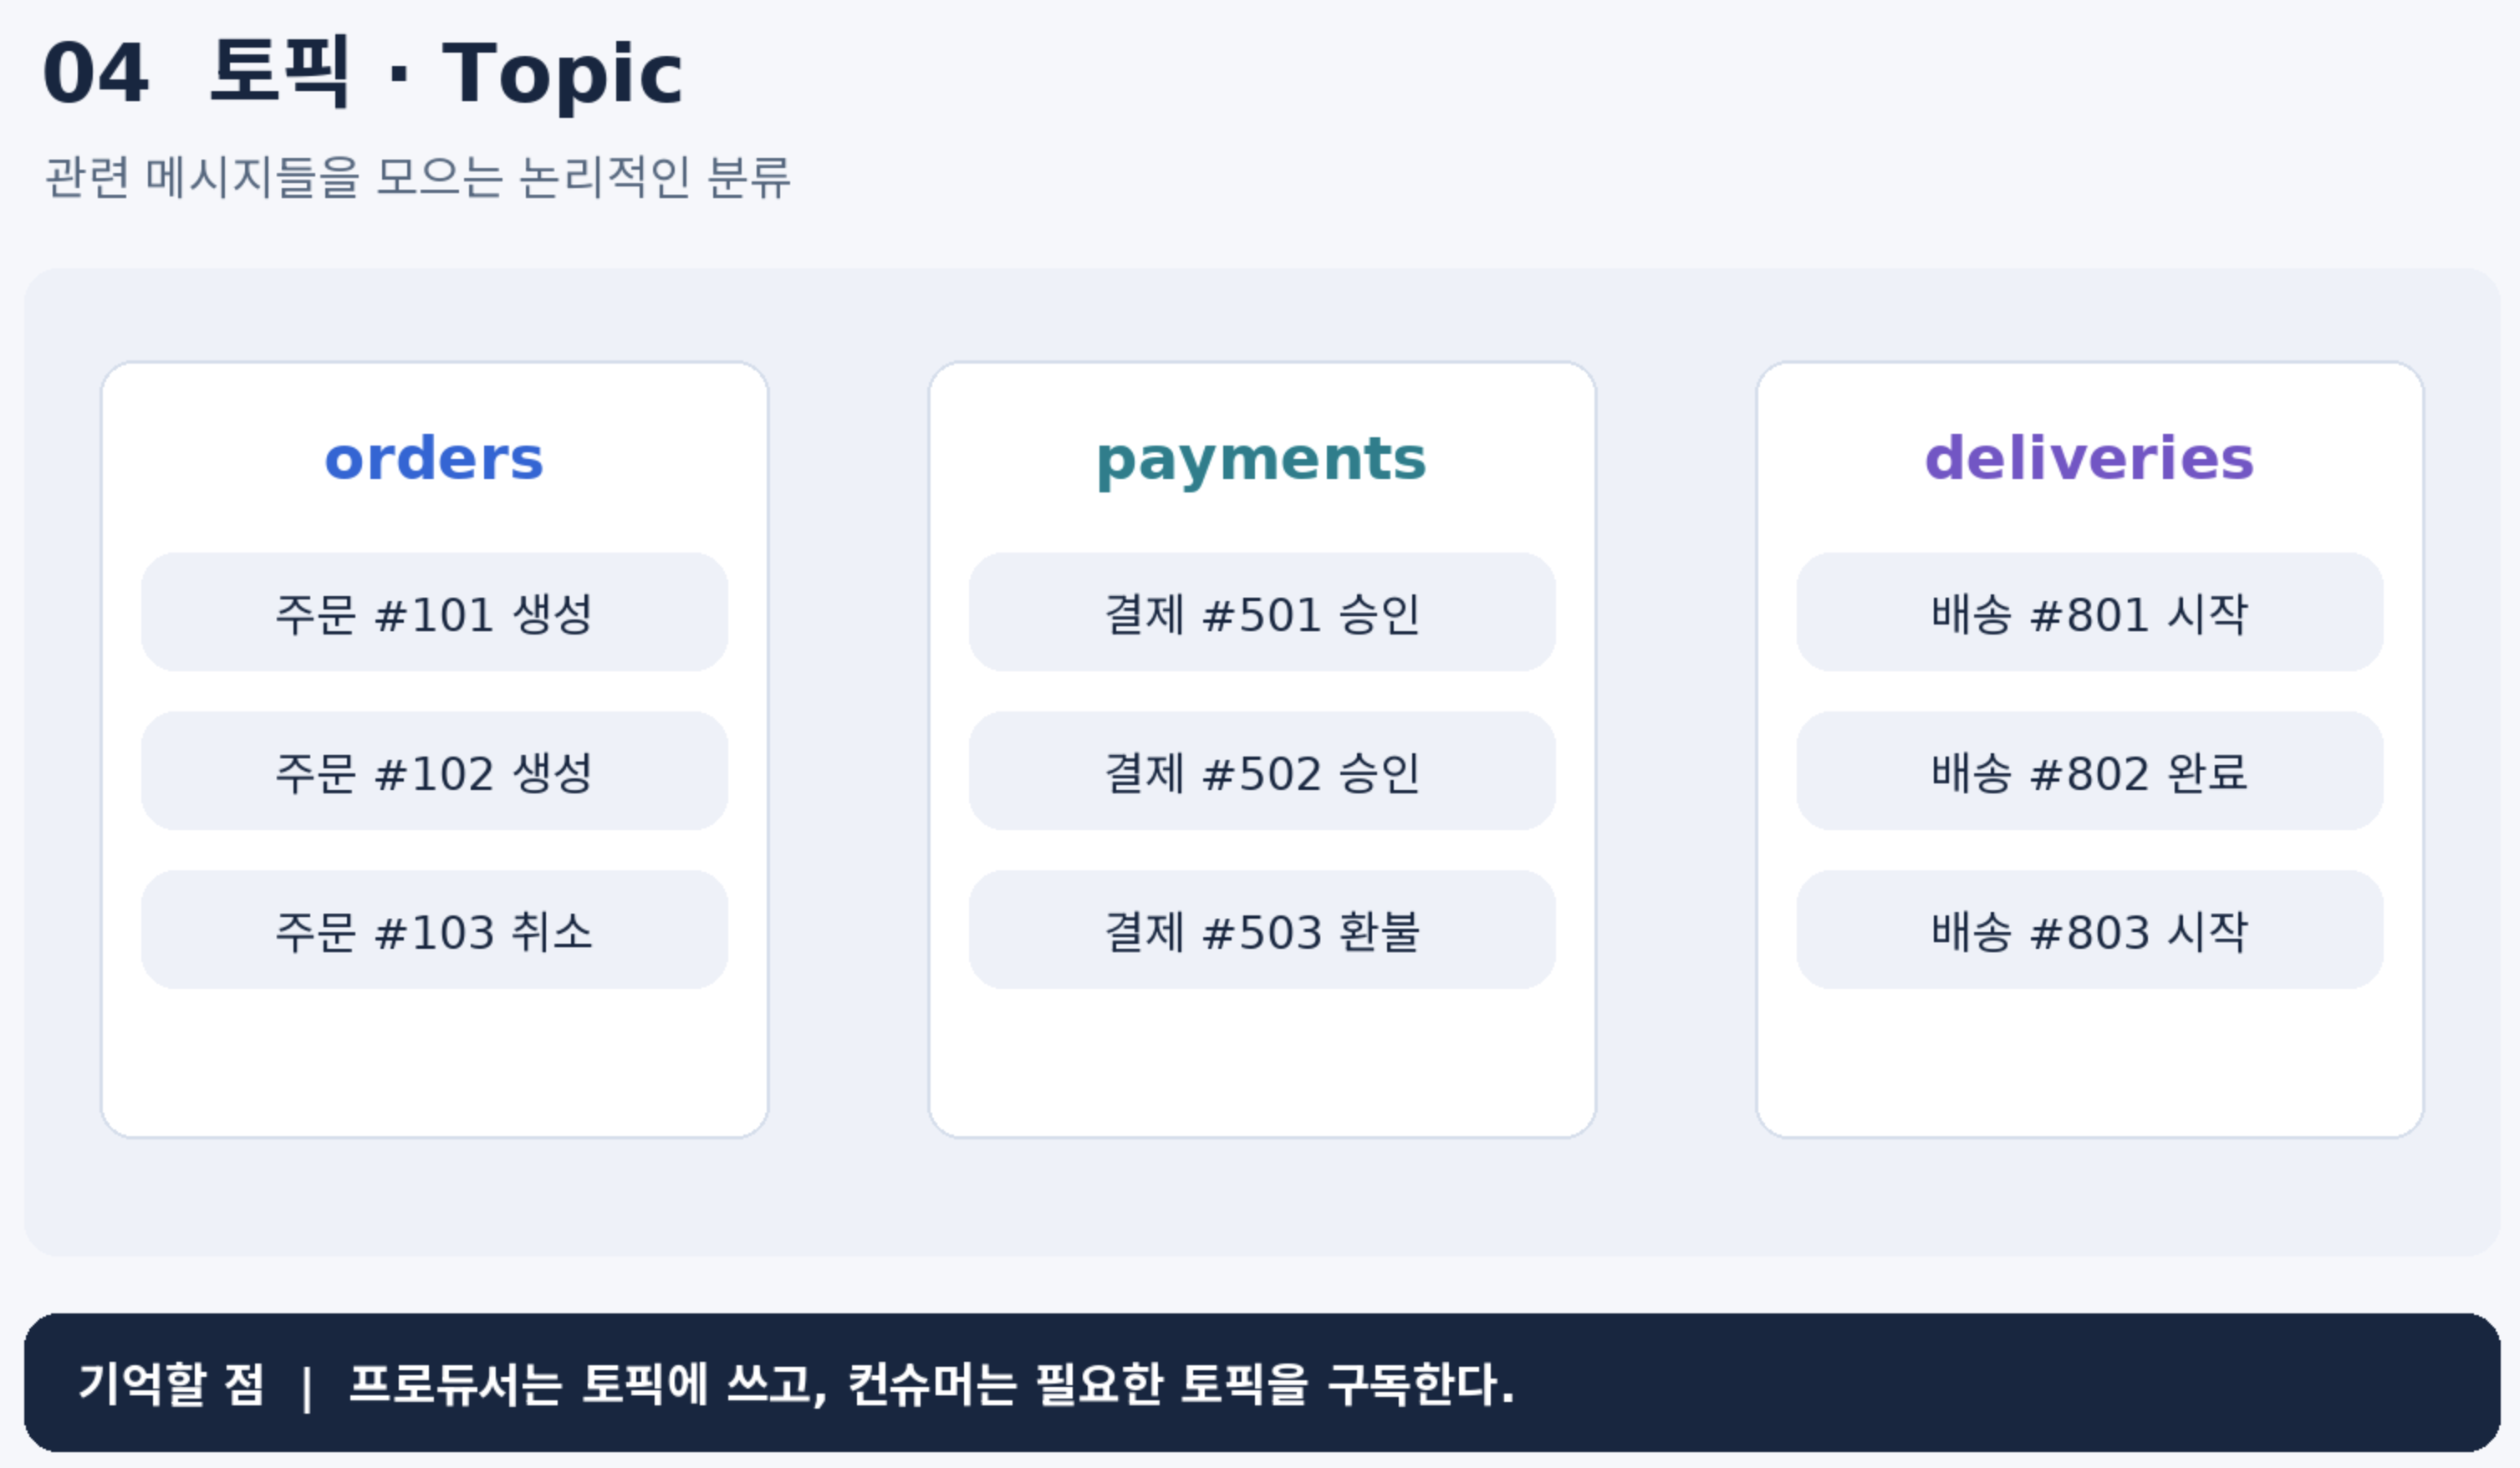
- Kafka에서 메시지를 종류 별로 분리하는 단위이다. (폴더의 느낌)
- 예를 들어 orders에는 주문 이벤트를, payments에는 결제 이벤트를 저장한다. 프로듀서는 특정 토픽에 메시지를 보내고, 컨슈머는 필요한 토픽을 구독한다.
- 컨슈머가 읽었다고 메시지가 바로 삭제되지는 않는다. 메시지는 토픽에 설정된 보관·정리 정책에 따라 유지된다.
5. 파티션(Partition) — 토픽을 나눈 저장 단위

- Topic을 여러 칸으로 나눈 것이 Partition 이다.
- 왜 파티션이 필요한가?
→ 여러 개의 메세지를 동시에 처리할 수 있도록 하기 위해서 - 비유하자면,
파티션이 1개 = 일하는 사람이 1명
파이션이 3개 = 일하는 사람이 3명
→ 파티션이 많을수록 동시에 처리할 수 있는 양이 증가한다.
파티션의 핵심 특징
- 하나의 파티션은 한 시점에 오직 하나의 Consumer만 처리할수 있다.
- 파티션을 늘릴 수는 있지만, 이미 존재하는 파티션을 줄일 수는 없다.
- 실무에서는 한 번에 많은 파티션을 생성하기 보다는 운영을 하면서 필요하면 증설을 하는 편이다.
- 파티션 안에서는 메세지가 "순서대로"만 쌓인다.
6. 브로커(Broker) — 카프카를 실행하는 서버
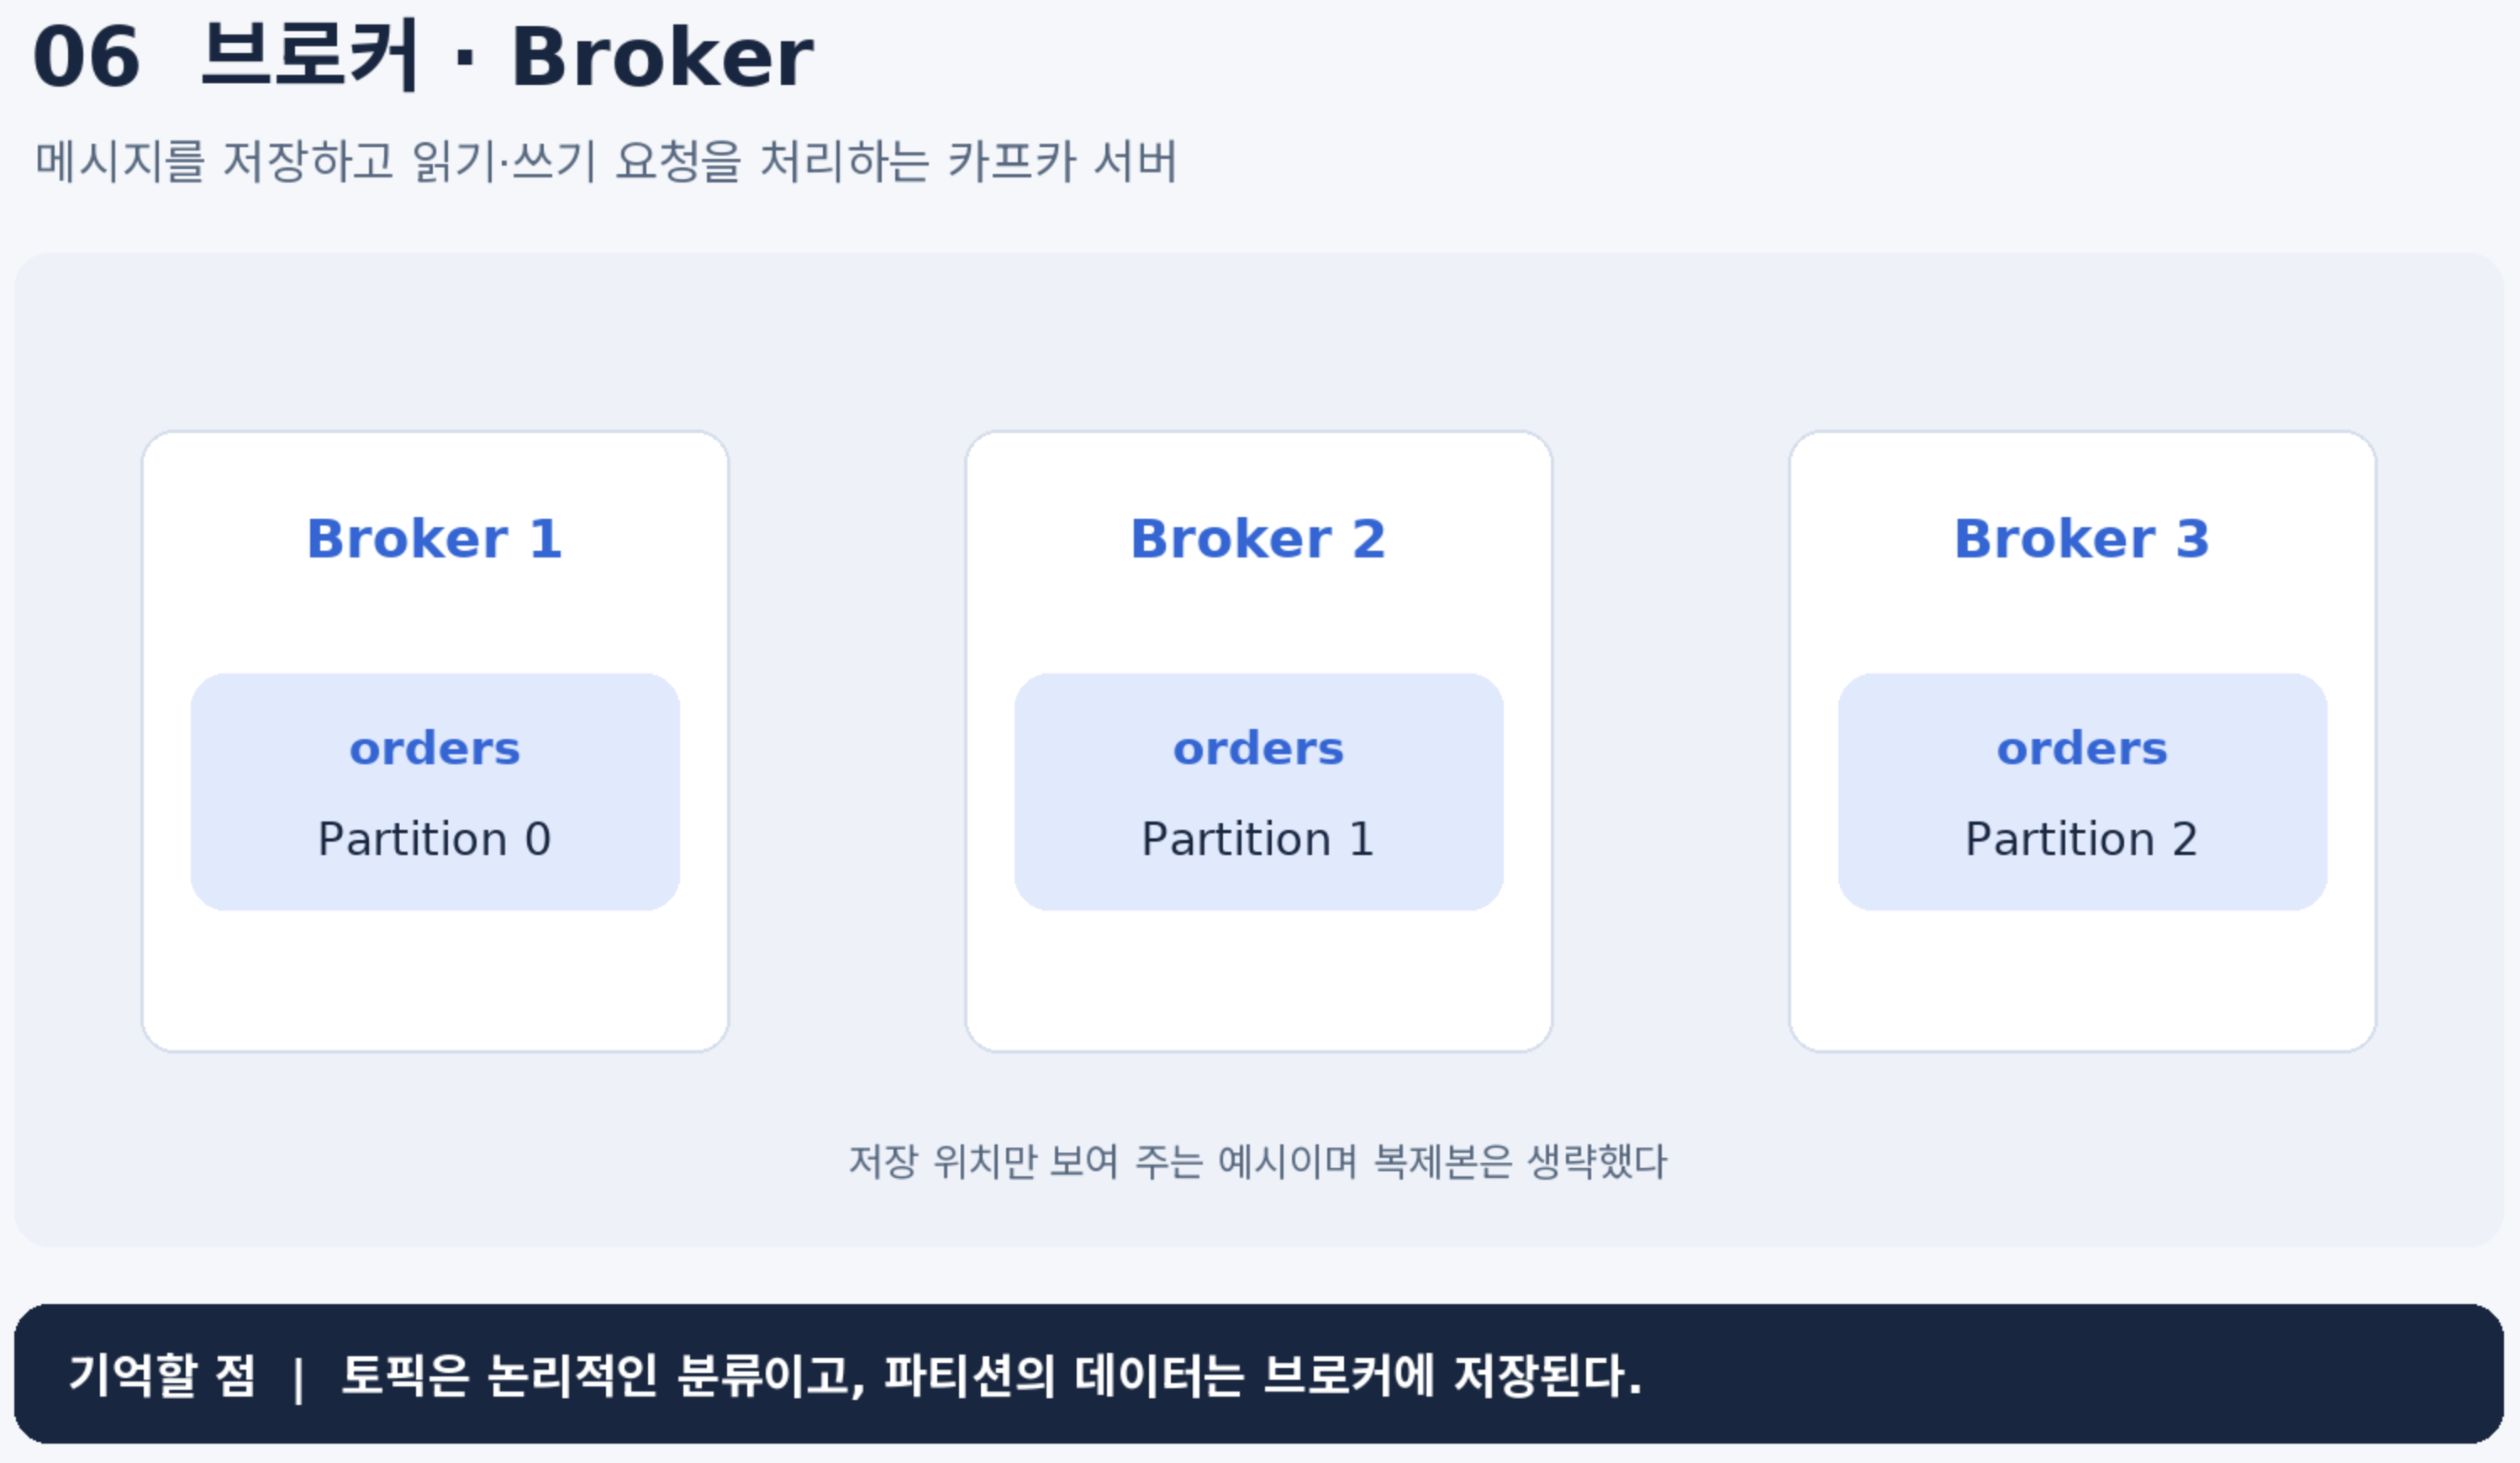
- 브로커는 메시지를 저장하고 읽기·쓰기 요청을 처리하는 카프카 서버다.
- 토픽은 데이터의 논리적인 분류, 브로커는 파티션을 실제로 저장하는 서버라고 구분하면 쉽다.\
브로커의 핵심 역할
- Producer가 보낸 메세지를 저장한다.
- Consumer가 메세지를 읽을 수 있도록 제공한다.
- Topic과 partition의 파일 구조를 관리한다.
7. 컨슈머 그룹(Consumer Group) — 함께 나누어 읽는 팀
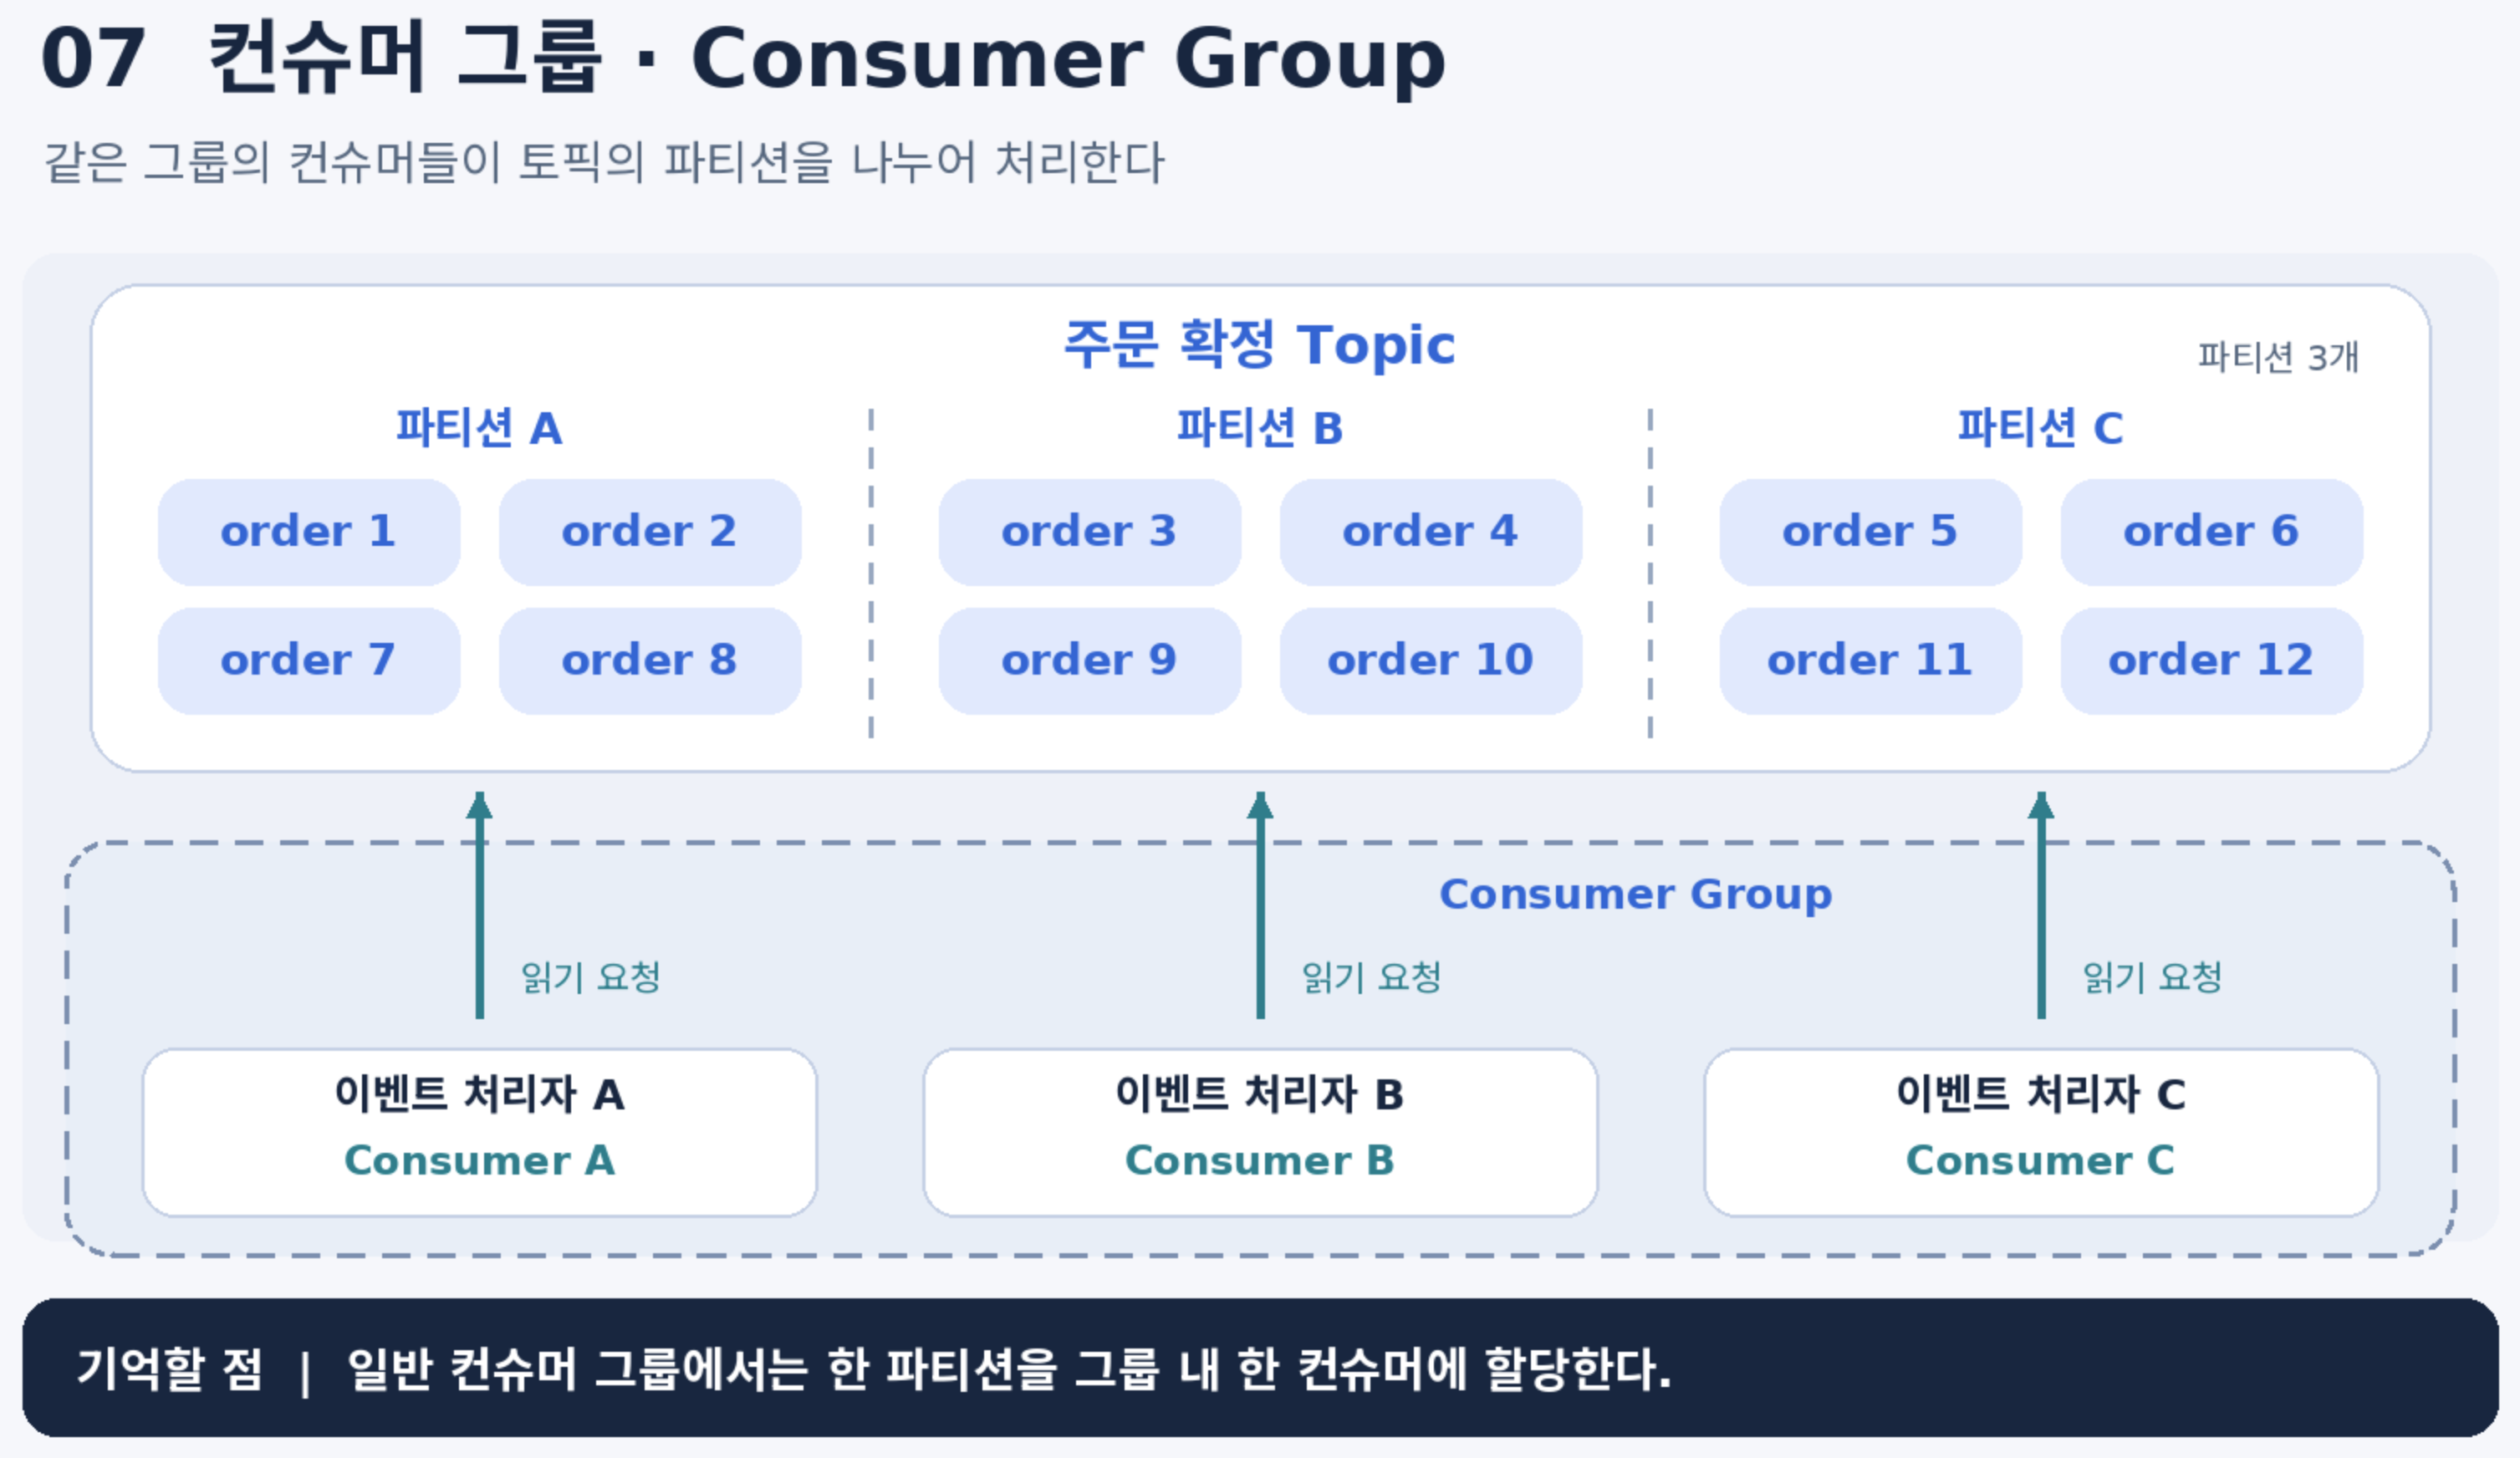
- 같은 목적의 Consumer들을 하나로 묶은 단위다.
- Consumer 그룹은 kafka의 병렬 처리 기능을 제공하는 핵심 구조이다.
- Partition과 Consumer 그룹이 같이 더해져야만 병렬 처리가 성공적으로 되는 것이다.
- 소속된 컨슈머들이 어디까지 읽었는지 offset을 기록합니다.
- 소속된 컨슈머들을 파티션에 배치합니다.
Consumer Group의 필요성
- 메세지가 많아지면 Consumer 1개로는 처리 속도가 부족하다.
- 여러 Consumer가 하나의 팀처럼 협업해서 처리해야 한다.
- kafka는 "Partition을 여러 Consumer에 나누어 제공"하여 병렬 처리를 가능하게 한다.
8. 오프셋(Offset) — 메시지의 위치와 읽기 진행 상황
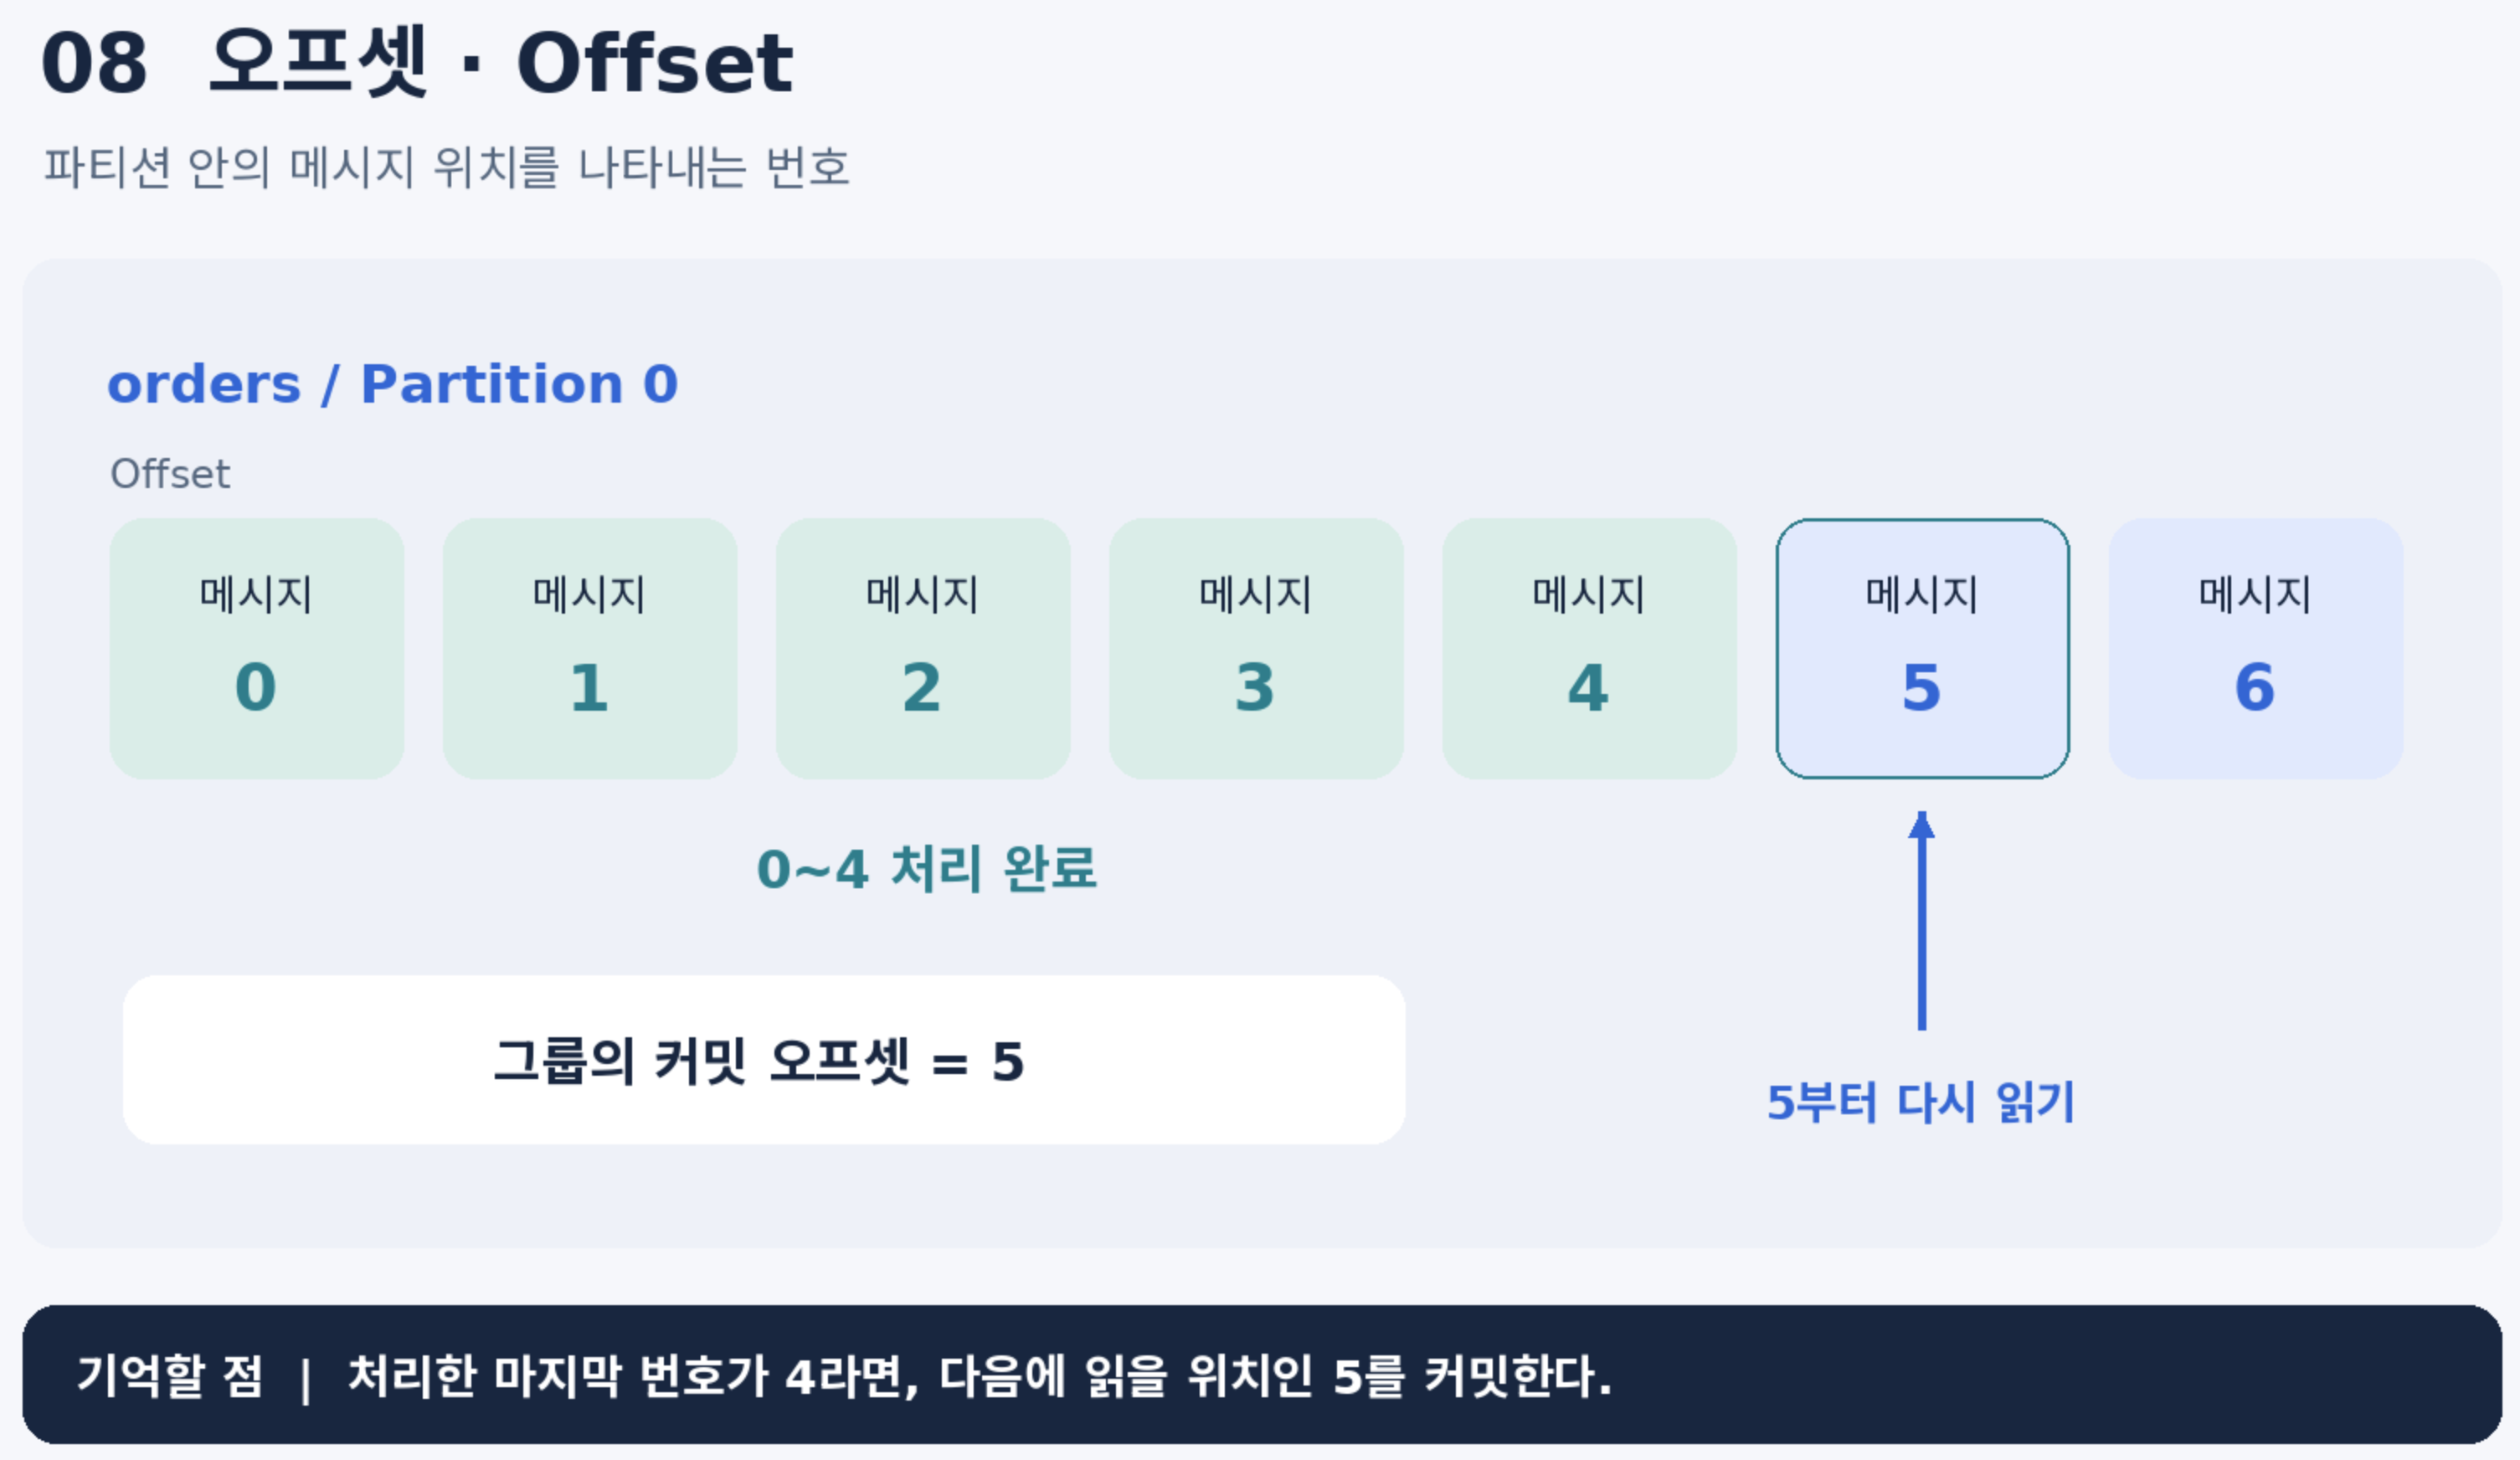
- 파티션 내부에서 메세지가 저장된 순서를 나타내는 번호이다.
- kafka는 메세지를 파티션의 끝에 차곡차곡 쌓아두는데, 파티션 안에 메세지가 저장될 때 메세지마다 자동으로 0,1,2,3...과 같은 번호(offset)가 자동으로 붙는다.
- Offset은 해당 Partition 내에서만 유효하며, 다른 Partition에서는 별개로 관리됩니다.
Offset을 따로 관리하는 이유
Consumer Group은 메세지를 읽을 때, “어디까지 읽었는지”를 Kafka 에 기록합니다.
- 중복해서 같은 메시지를 반복 처리하지 않도록
- 또 놓치는 메시지가 없도록
- 서버가 재시작되더라도 중단했던 위치부터 다시 읽을 수 있도록
Consumer Group이 Offset을 직접 관리하며,Partition 별로 Offset을 따로 관리합니다.
→ 이 구조 덕분에 Kafka는 병렬 처리와 안정적인 메시지 소비가 모두 가능해집니다.
단일 브로커의 한계
Kafka는 브로커 한 대만으로도 동작한다. 로컬 개발이나 테스트 환경에서는 이렇게 가볍게 띄워 쓰는 경우가 많다.
하지만 이 구성을 그대로 실서비스에 가져가면 구조적인 문제가 여러 가지 드러난다.
단일 브로커 환경에서 생기는 대표적인 한계 네 가지를 차례로 살펴보자.
1. 브로커가 죽으면 Kafka 전체가 멈춘다
브로커가 한 대뿐이라면 그 서버가 곧 Kafka 전체다. 이 서버가 다운되는 순간 다음과 같은 일이 벌어진다.
- Producer는 메시지를 저장할 곳이 없어 전송에 실패한다.
- Consumer는 메시지를 읽어올 곳이 없어 소비가 중단된다.
- Kafka에 의존하는 서비스들까지 연쇄적으로 멈추면서 장애가 전체 시스템으로 번진다.
한 곳이 무너지면 전체가 무너지는 전형적인 단일 장애 지점(SPOF, Single Point of Failure) 구조다.
2. 수평 확장(Scale-out)이 불가능하다
트래픽이 늘어나도 요청을 나눠 받을 서버가 없다.
- 모든 Partition이 한 대의 브로커에 몰려 있어, 서버 한 대가 모든 읽기·쓰기 요청을 감당해야 한다.
- CPU, 메모리, 디스크 I/O, 네트워크 대역폭 중 하나만 한계에 닿아도 곧바로 병목이 생긴다.
- Partition 수를 늘려도 결국 같은 서버 안에서 나눠 쓰는 것이라 처리량이 크게 늘지 않는다.
Kafka의 강점인 "Partition을 여러 브로커에 분산해 병렬로 처리한다"는 설계를 전혀 활용하지 못하는 셈이다.
3. 모든 데이터가 한 서버에만 있다
단일 브로커에서는 복제본(Replica)을 둘 다른 브로커가 없다.
Replication Factor를 1보다 크게 설정할 수 없기 때문에, 메시지는 오직 그 서버의 디스크에만 존재한다.
- 디스크가 고장 나면 저장된 메시지가 통째로 사라질 수 있다.
- 백업이 있더라도, 마지막 백업 이후에 들어온 메시지는 복구할 방법이 없다.
4. 고가용성(High Availability)을 보장할 수 없다
큰 장애가 아니어도 서비스가 멈춘다.
- 잠깐의 네트워크 단절
- 보안 패치나 설정 변경을 위한 서버 재부팅
- Kafka 버전 업그레이드
그래서 필요한 것이 다음에 나오는 "클러스터"이다.
Kafka 클러스터
Kafka 클러스터는 여러 브로커가 하나의 Kafka처럼 동작하는 구조이다.
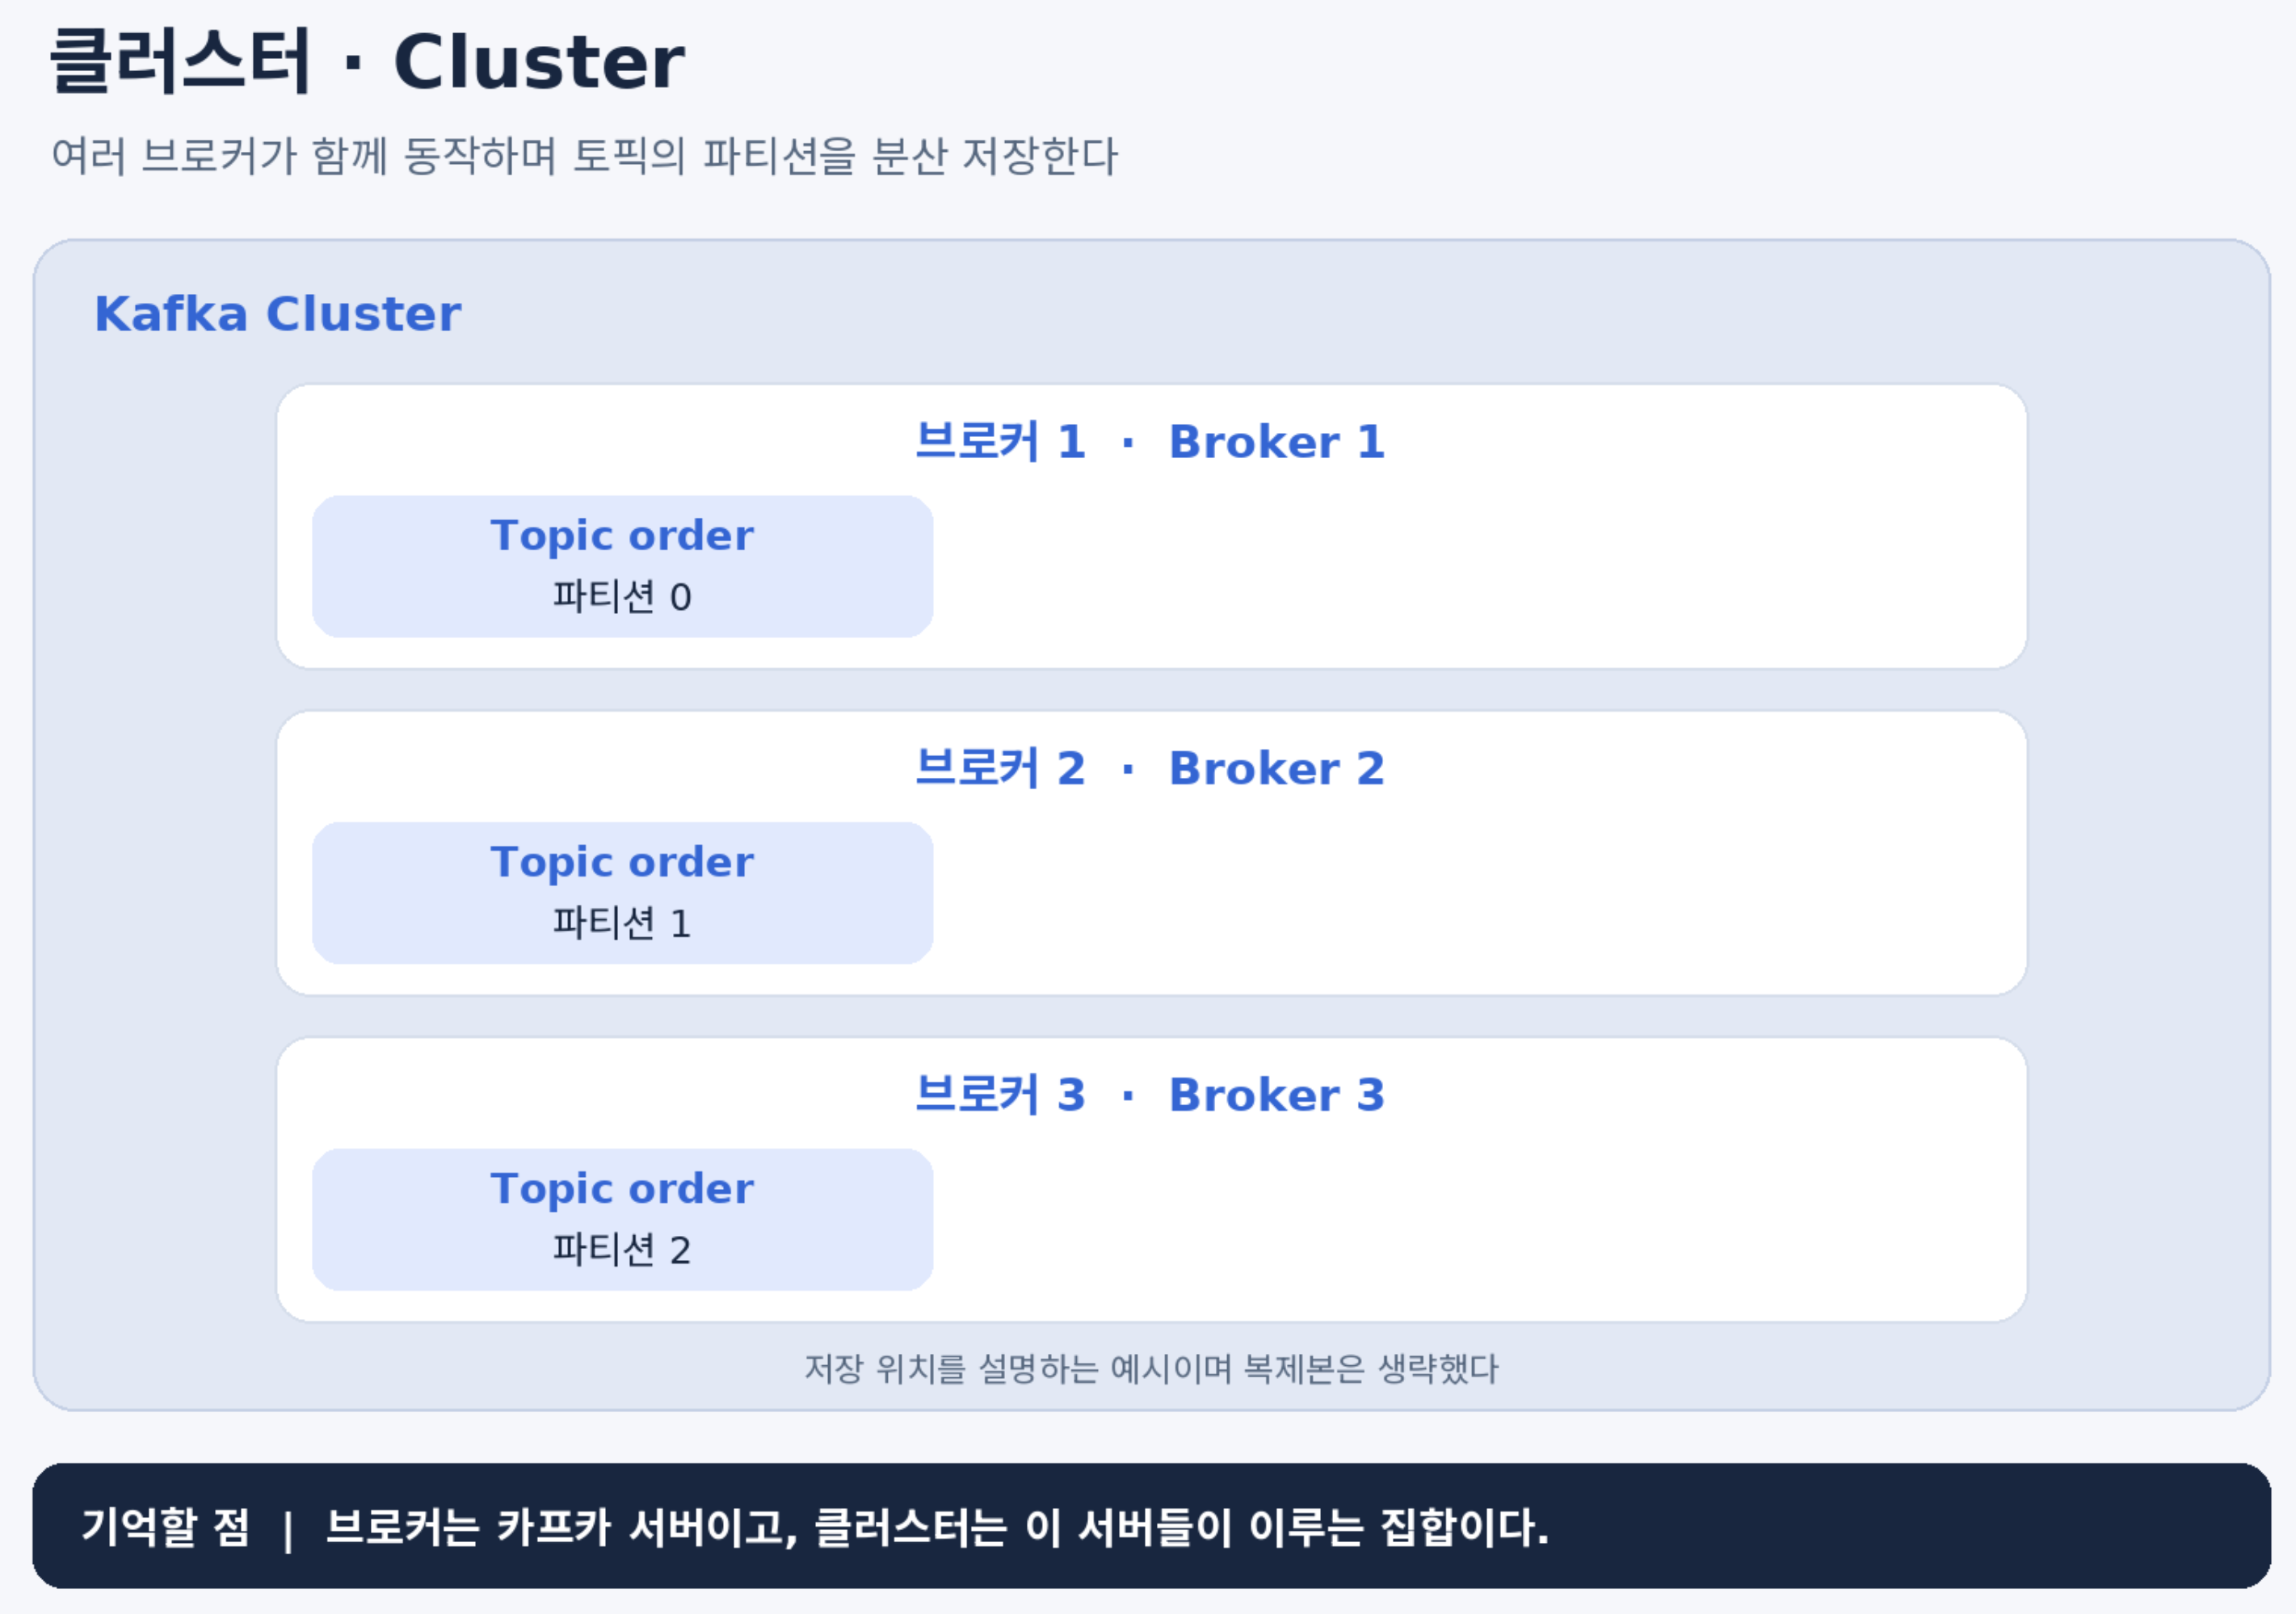
- Partition을 여러 브로커에 분산해 저장하여 병렬 처리 성능을 확장할 수 있다.
- 장애가 발생하면 다른 브로커가 역할을 자동으로 인계 받아 전체 시스템의 고가용성(High Availability)을 확보한다.
Partition 분산과 Replica
브로커를 여러 대 두는 것만으로는 부족하다!!!
데이터를 브로커들에 어떻게 나누고, 어떻게 지킬지가 정해져야 한다. 그 역할을 하는 것이 Partition 분산과 Replica다.
Partition 분산 - 데이터를 나눈다
Topic은 여러 개의 Partition으로 나뉜다.
이 Partition들을 여러 브로커에 나눠 배치하면, 요청이 한 서버에 몰리지 않고 흩어진다.
- 같은 Key를 가진 메시지는 항상 같은 Partition으로 간다.
- 메시지 순서는 같은 Partition 안에서만 보장된다.
- Partition 수만큼 Consumer가 병렬로 읽을 수 있다.
하지만 이것만으로는 위험하다. Broker 1이 죽으면 Partition 0의 데이터도 함께 사라진다.
Replica - 나눈 데이터를 복사한다
그래서 Kafka는 각 Partition의 복사본을 다른 브로커에도 저장한다.
이 복사본이 Replica이고, 몇 개를 둘지를 Replication Factor(RF)라고 한다.
Replica는 역할이 나뉜다.
Leader
- Producer와 Consumer가 실제로 통신하는 대상으로, Leader와만 통신한다.
- 모든 read/write 작업을 Leader가 처리한다.
- 장애가 발생하면 새로운 리더가 자동으로 선출된다.
- 해당 파티션의 원본을 담당하는 복제본. Producer가 보내는 쓰기와 Consumer가 하는 읽기는 전부 Leader를 거친다.
Follower
- 같은 파티션의 사본을 들고 있는 복제본. Leader가 받은 데이터를 그대로 복사해 따라가기만 하고, 평소엔 Producer/Consumer와 직접 통신하지 않는다.
- Leader 장애 발생 시 Follower가 자동으로 Leader로 승격된다.
- Follower에서 장애가 발생한 경우에는 장애가 복구된 이후부터 Leader의 데이터를 다시 저장하기 시작한다. (동기화)
두 구조를 합치면
Partition 3개, RF 3, 브로커 3대인 경우다.
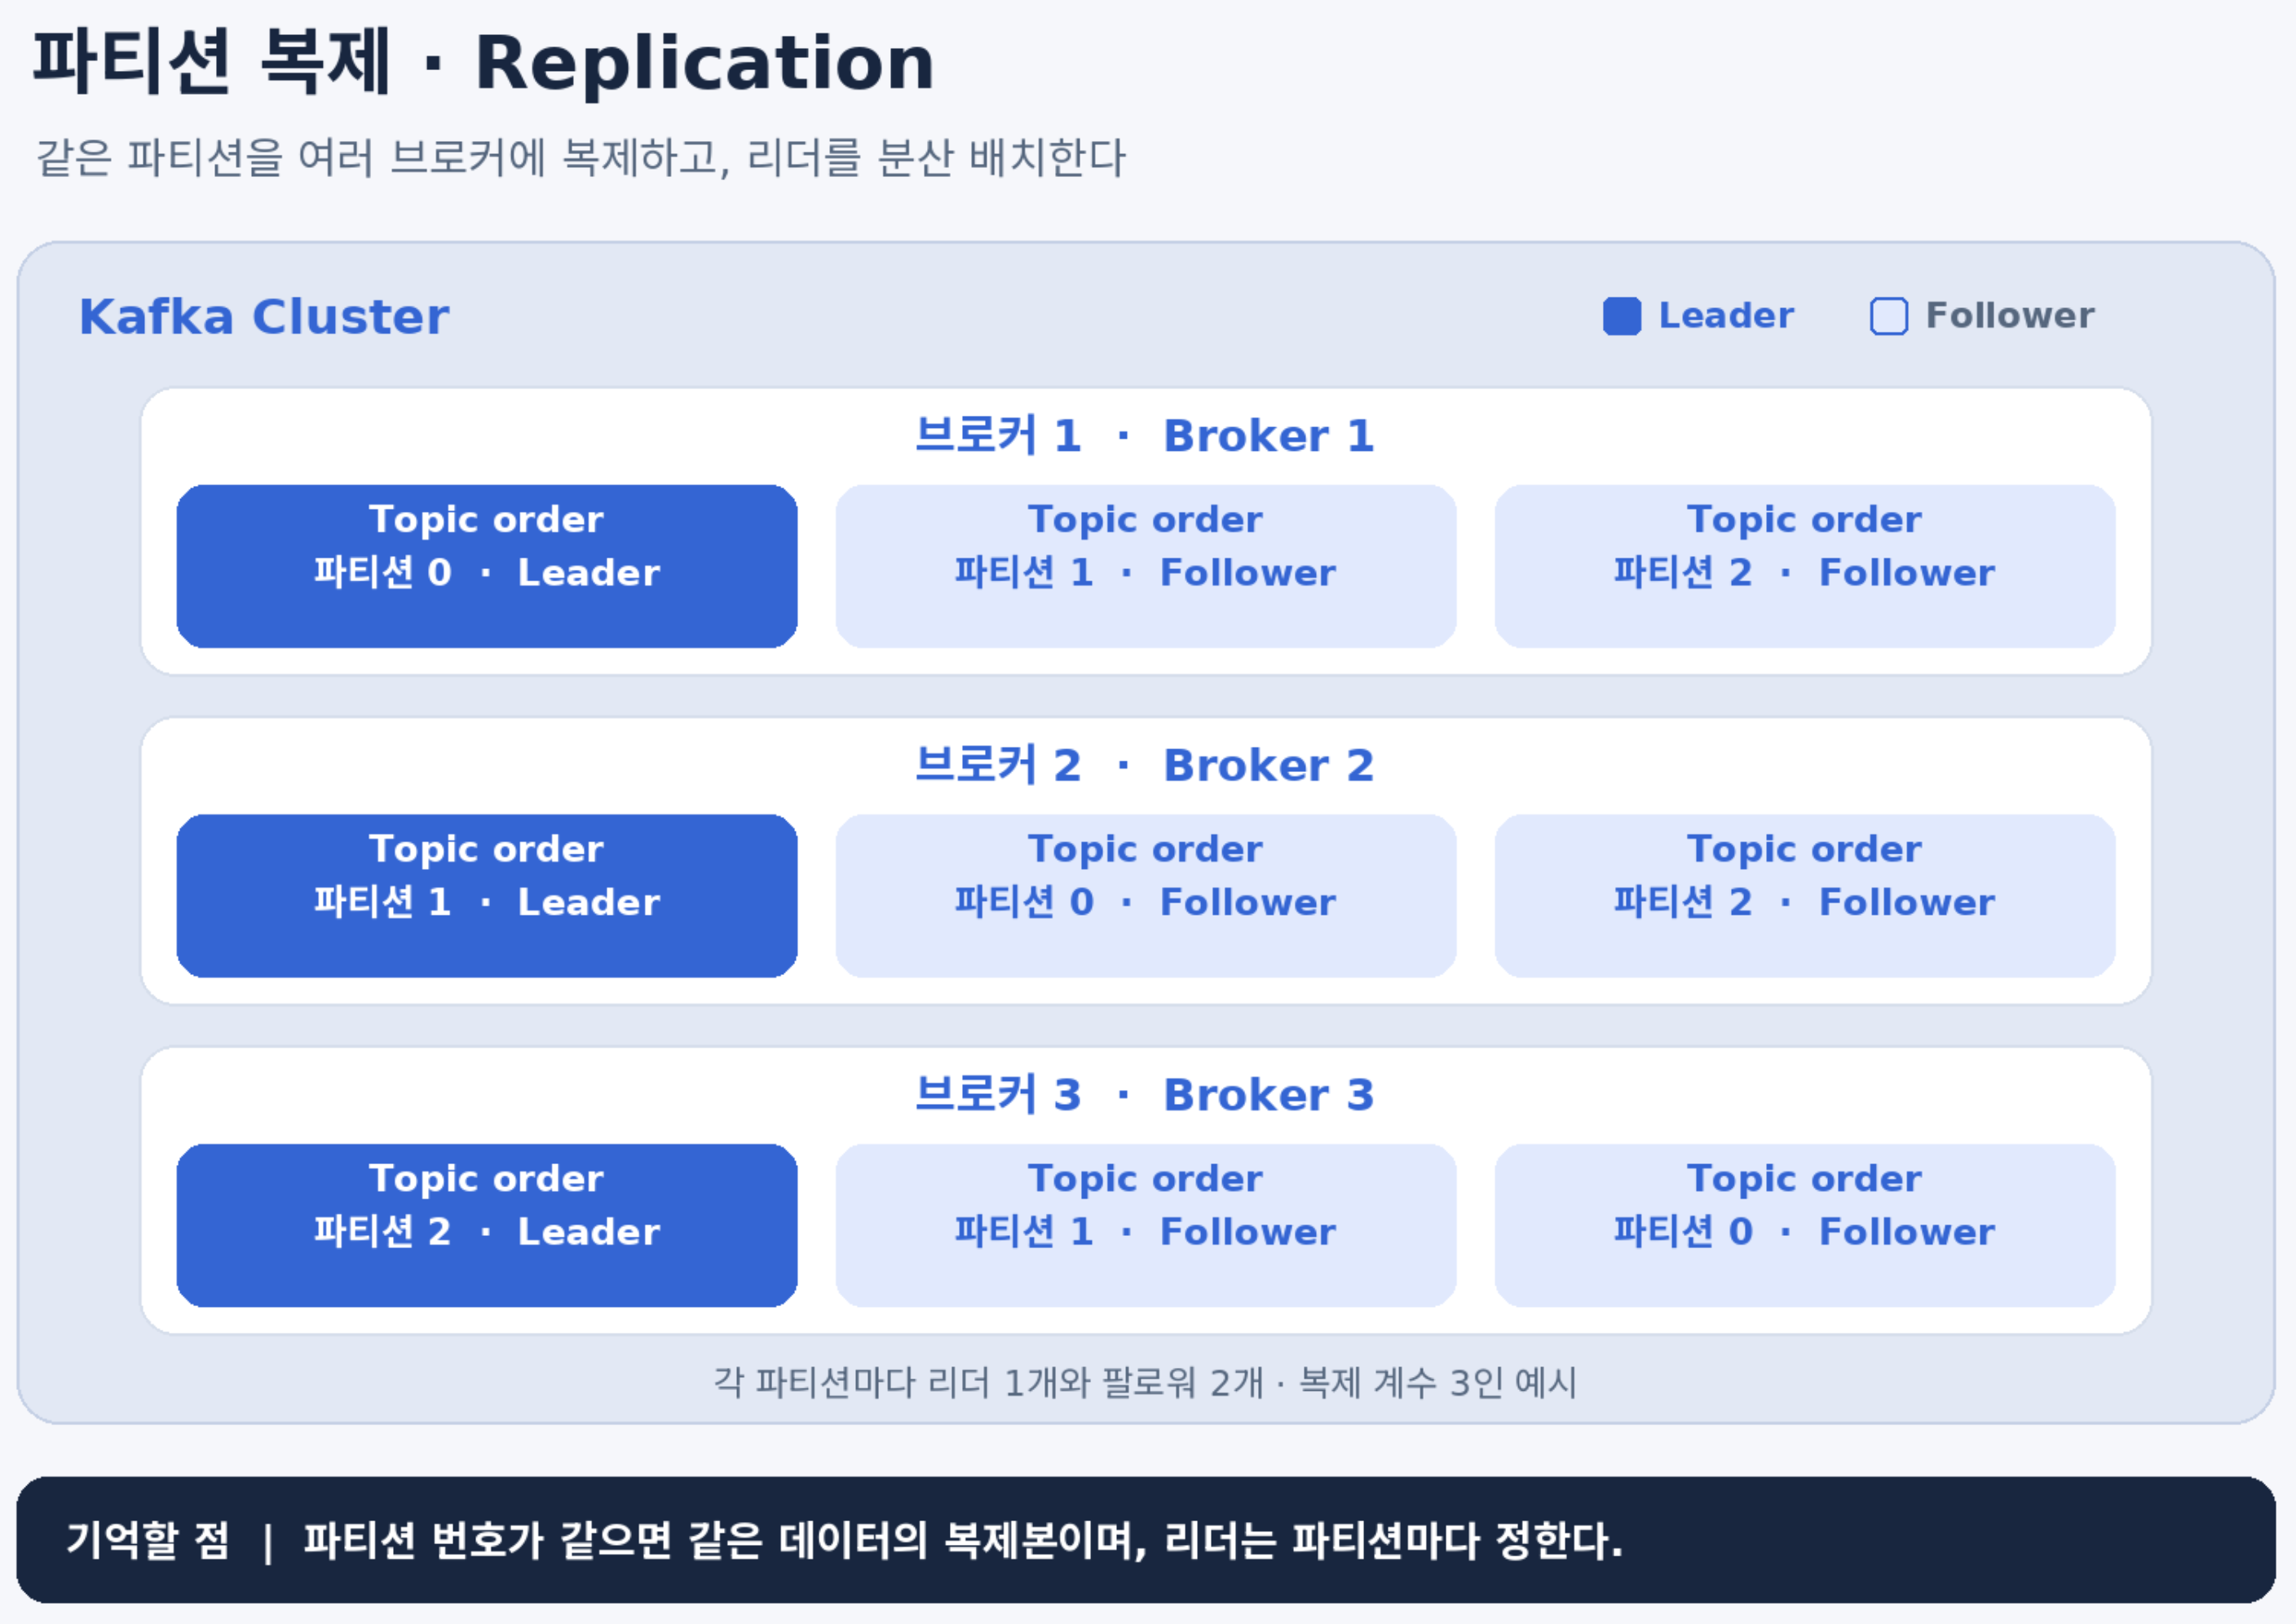
- 세로로 보면 Partition 분산이다. Leader가 브로커마다 나뉘어 부하가 분산된다.
- 가로로 보면 Replica다. 같은 Partition이 세 브로커에 복사되어 있어, 한 대가 죽어도 데이터가 남는다.
같은 Partition의 Replica는 항상 다른 브로커에 둔다. 그래서 RF는 브로커 수보다 클 수 없다.
Controller - 클러스터의 관리자
브로커가 여러 대 있으면 누군가는 전체 상황을 보고 결정을 내려야 한다.
어느 브로커가 살아 있는지, Partition의 Leader는 누구인지, 브로커가 죽으면 누가 Leader를 이어받을지 같은 것들이다.
이 일을 맡는 것이 Controller다.
Controller가 하는 일
- 브로커 관리: 어떤 브로커가 클러스터에 들어오고 나갔는지, 살아 있는지 확인한다.
- Leader 선출: 브로커가 죽으면 그 브로커가 Leader였던 Partition의 새 Leader를 ISR 중에서 뽑는다.
- 메타데이터 관리: Topic 생성·삭제, Partition 수 변경, Replica 배치 같은 클러스터 정보를 관리하고 모든 브로커에 알린다.
정리하면 브로커는 데이터를 처리하고, Controller는 클러스터를 관리한다.
Controller도 여러 대 둔다
Controller가 하나뿐이면 Controller가 죽는 순간 클러스터를 관리할 주체가 사라진다. 그래서 Controller도 보통 3대를 둔다.
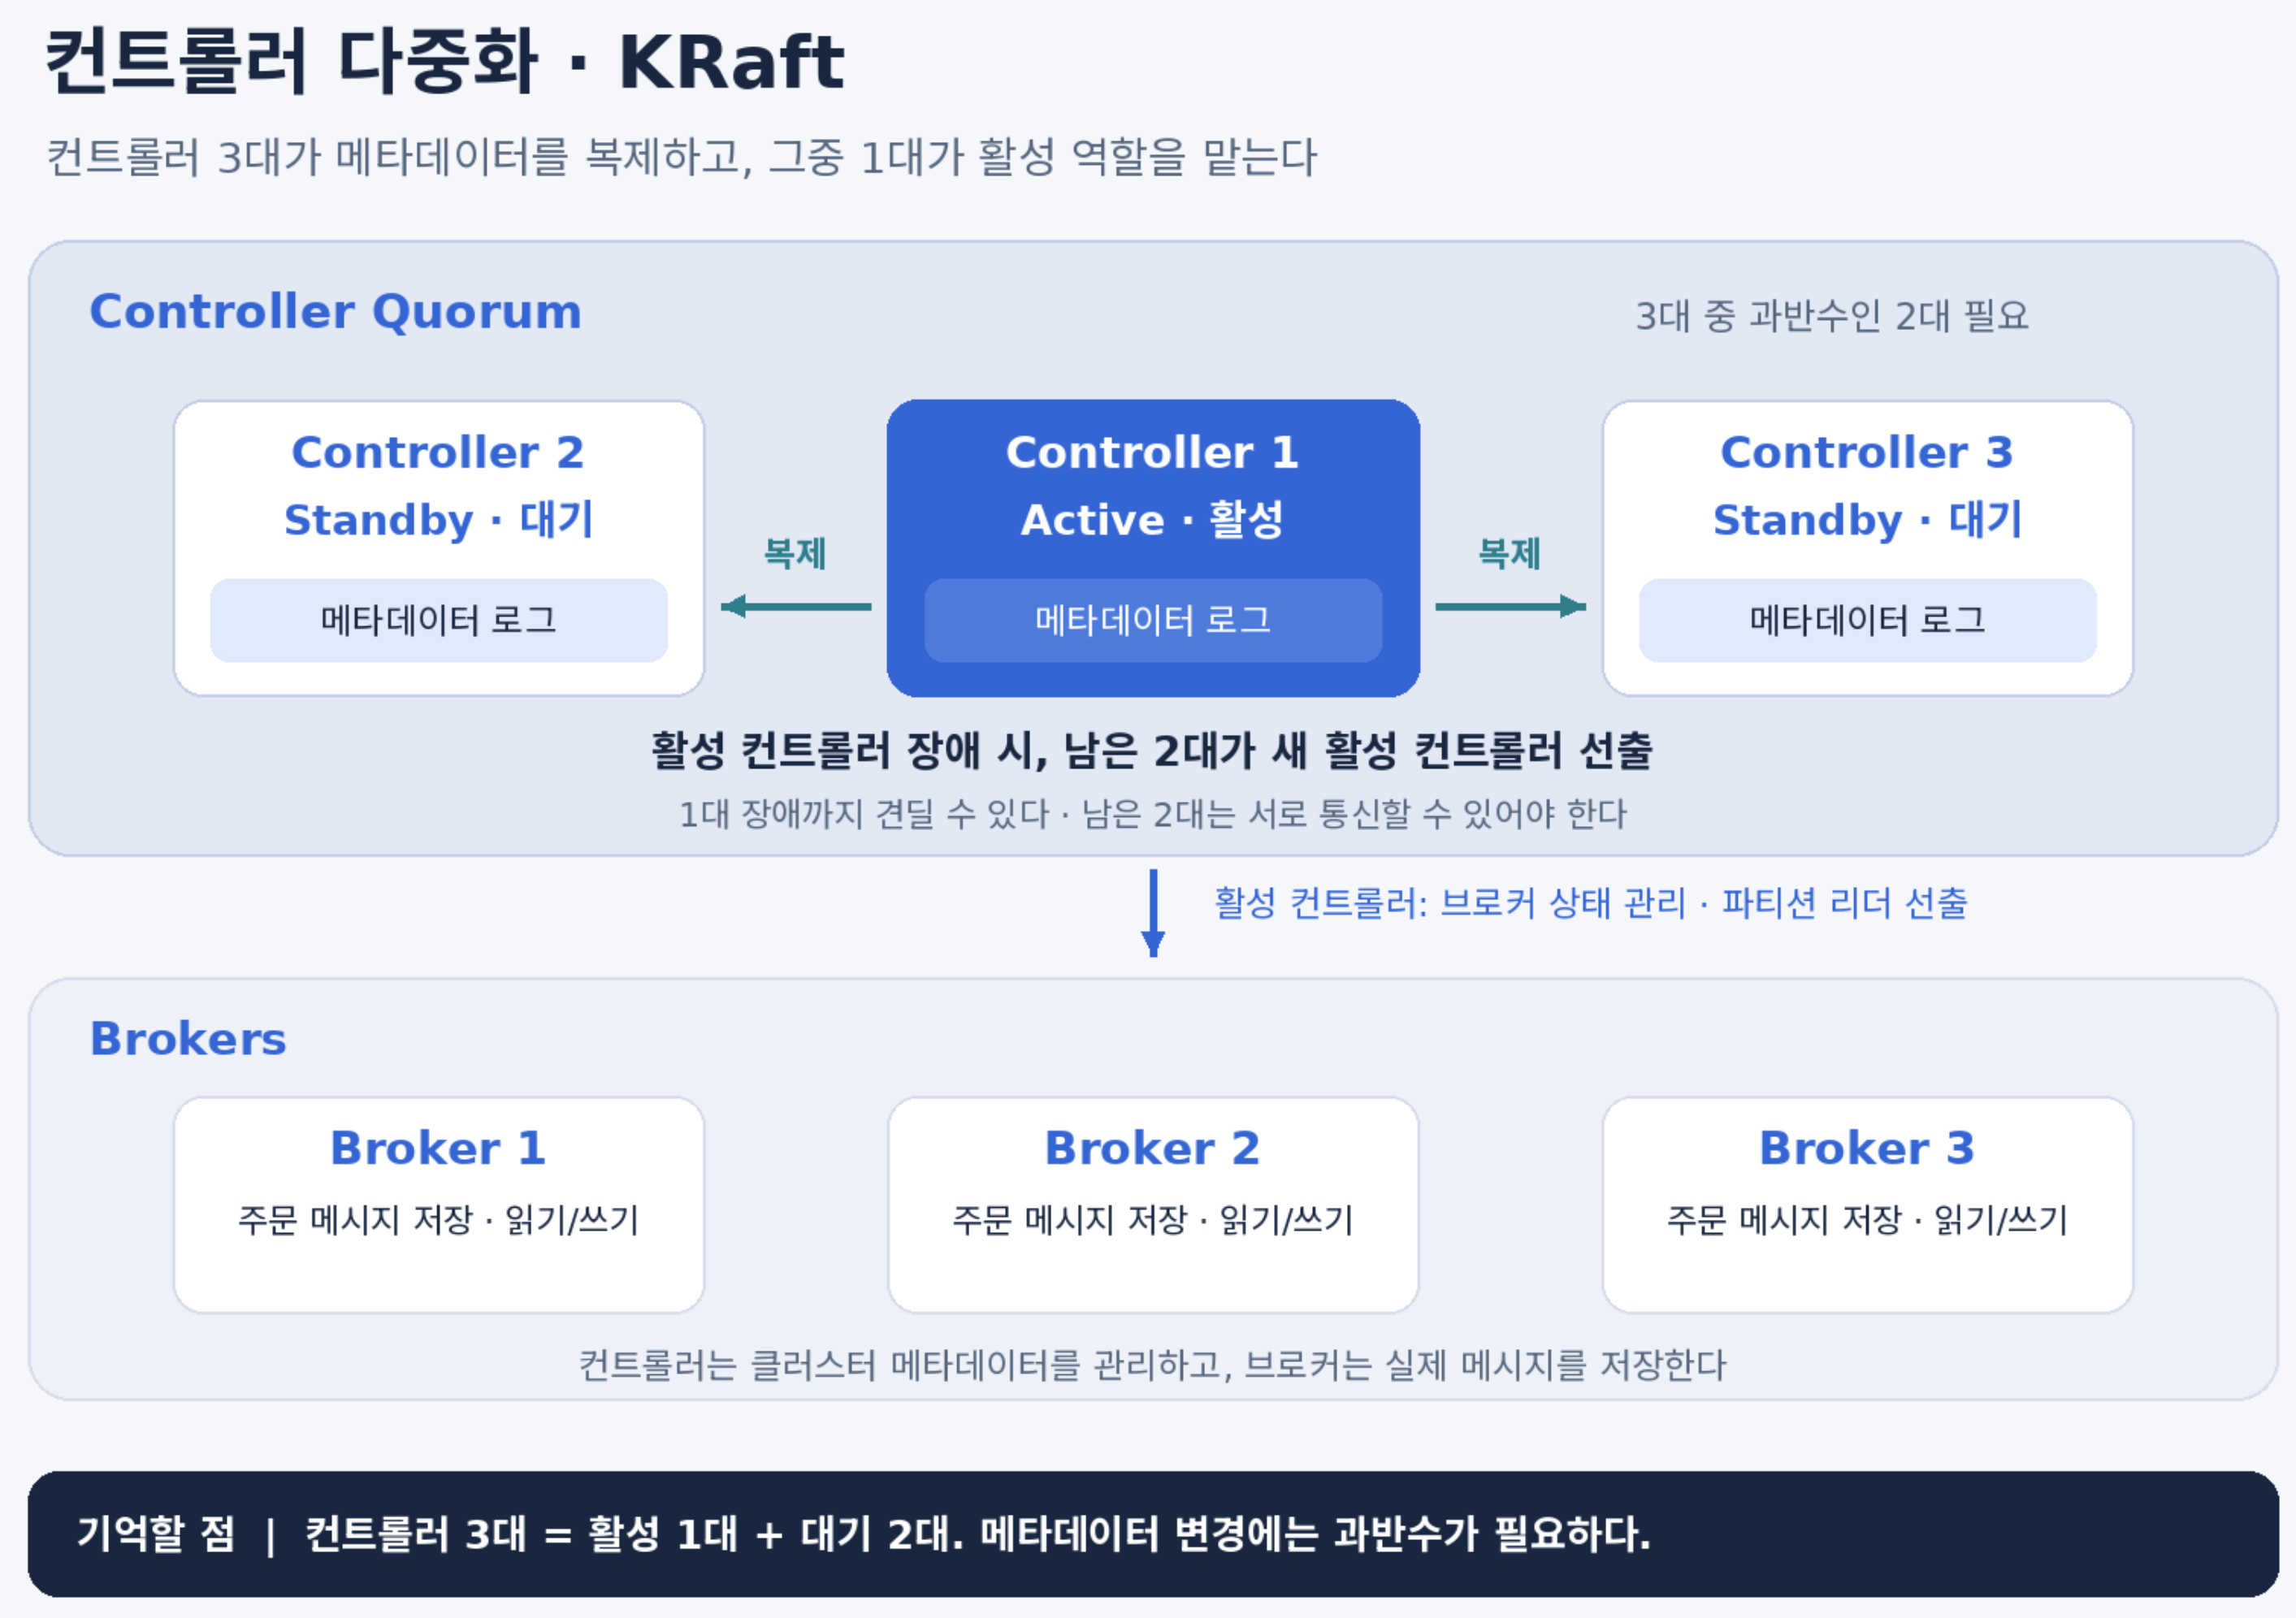
- 실제로 일하는 Controller는 하나이고, 이를 Active Controller라고 한다.
- 나머지는 같은 메타데이터를 복제해 두고 대기한다.
- Active Controller가 죽으면 남은 Controller 중 하나가 새 Active Controller로 선출된다.
이 선출과 메타데이터 복제는 Raft 합의 알고리즘으로 이뤄진다. 과반수가 살아 있어야 동작하므로, 3대 중 1대가 죽어도 클러스터는 정상적으로 관리된다.
Consumer Group과 병렬 처리는 실제로 어떻게 동작하는가
Kafka는 토픽의 메시지를 여러 파티션(Partition)에 나누어 저장한다.
Consumer Group은 같은 목적의 Consumer들을 묶어, 파티션을 나누어 맡게 하는 단위다.
쉽게 말해 파티션은 나누어 맡을 작업 구역이고, Consumer Group은 그 구역을 분담하는 팀이다.
아래 내용은 일반적인 Consumer Group의 자동 파티션 할당을 기준으로 설명한다.
1. 파티션 수와 Consumer 수에 따른 작업 분담
Topic A에 파티션이 3개 있고, 하나의 Consumer Group이 이 토픽만 구독한다고 가정해 보자.
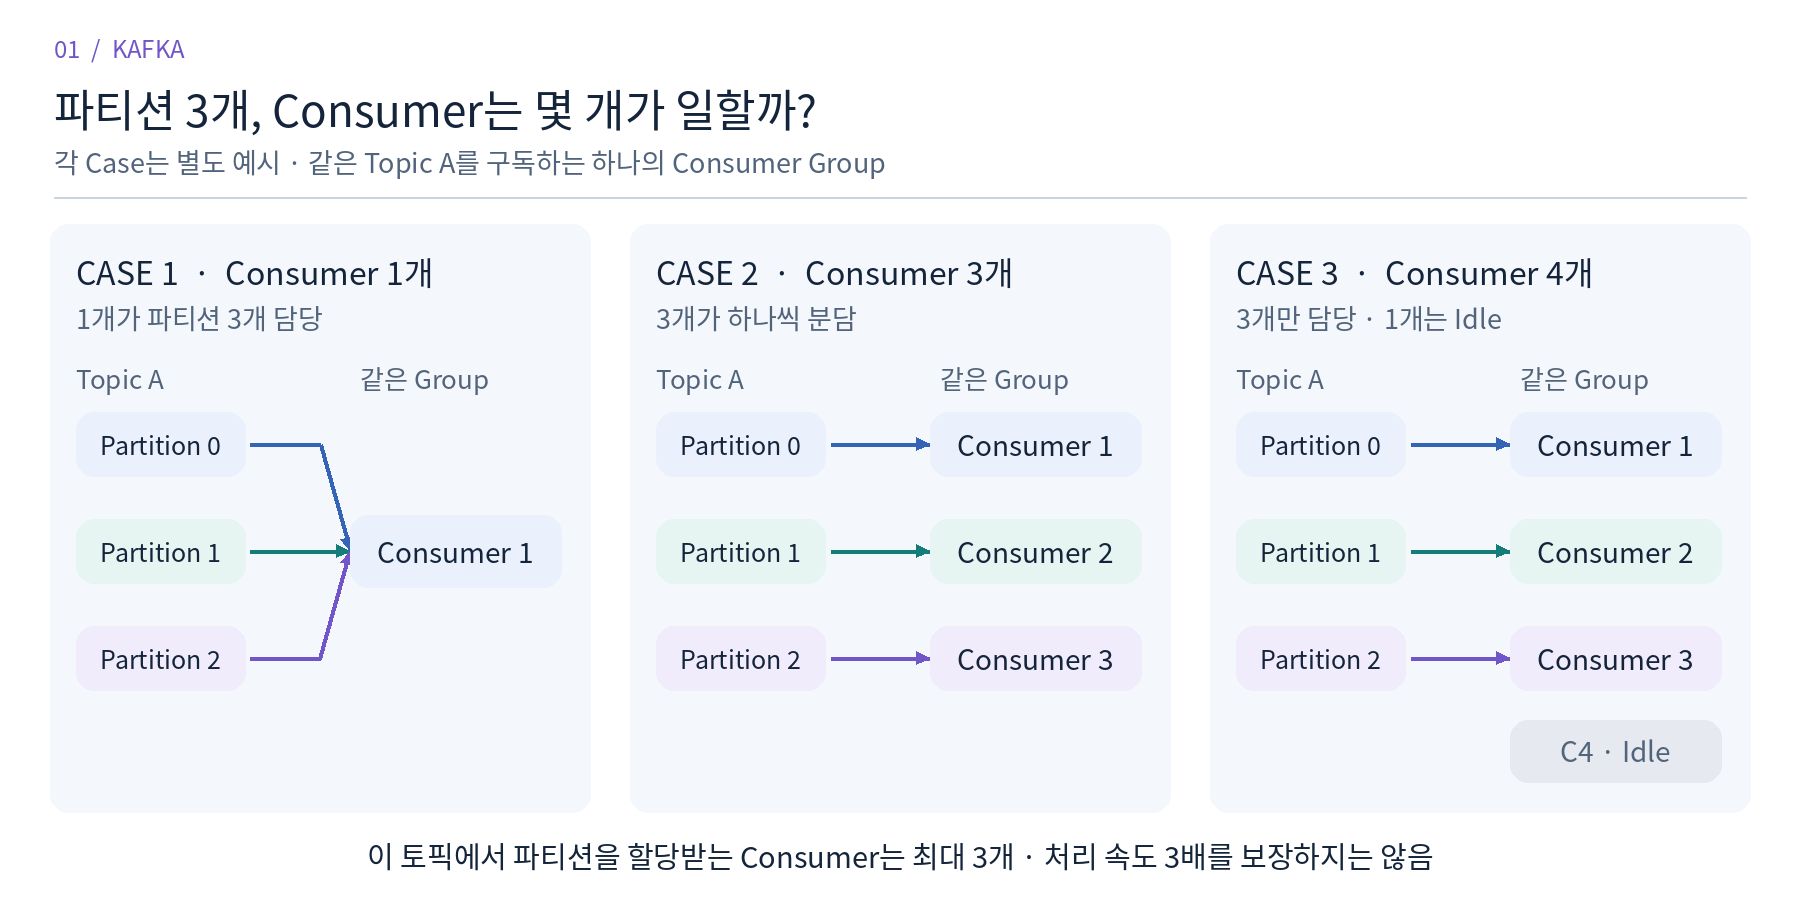
Case 1. Consumer가 1개인 경우
- 하나의 Consumer가 파티션 3개를 모두 담당한다.
- 여러 Consumer가 작업을 나누어 처리하는 효과는 없다.
- 다만 Consumer 내부에 별도 작업 스레드를 둘 수도 있으므로, 모든 형태의 병렬 처리가 불가능하다는 뜻은 아니다. 이 경우에는 처리 순서와 Offset 커밋을 추가로 설계해야 한다.
Case 2. Consumer가 3개인 경우
- 각 Consumer가 파티션 하나씩을 맡아 동시에 처리할 수 있다.
- 하지만 Consumer가 3개라고 처리량이 반드시 3배가 되지는 않는다. 특정 파티션에 메시지가 몰리거나 연결된 DB가 느리다면 기대한 만큼 빨라지지 않을 수 있다.
Case 3. Consumer가 4개인 경우
- 파티션은 3개이므로 Consumer 3개만 파티션을 할당받고, 나머지 1개는 대기한다.
- 같은 Consumer Group에서는 하나의 파티션을 동시에 여러 Consumer에게 할당하지 않는다. 반대로 하나의 Consumer가 여러 파티션을 맡는 것은 가능하다.
같은 그룹에서 해당 토픽의 파티션을 할당받아 일할 수 있는 Consumer 수는 파티션 수를 넘지 못한다.
Consumer가 추가되거나 빠지면 파티션 담당이 다시 조정될 수 있다. 이를 리밸런싱(Rebalancing)이라고 한다.
2. Consumer Group별 Offset 관리
Offset은 파티션 안에서 메시지가 저장된 위치를 나타내는 번호다. 각 파티션에서 독립적으로 증가한다.
따라서 파티션 0의 offset 3과 파티션 1의 offset 3은 서로 다른 메시지를 가리킨다.
Consumer Group은 이 위치를 바탕으로 진행 상황을 기록한다. 같은 토픽을 읽더라도 그룹마다, 파티션마다 진행 위치가 따로 관리된다.
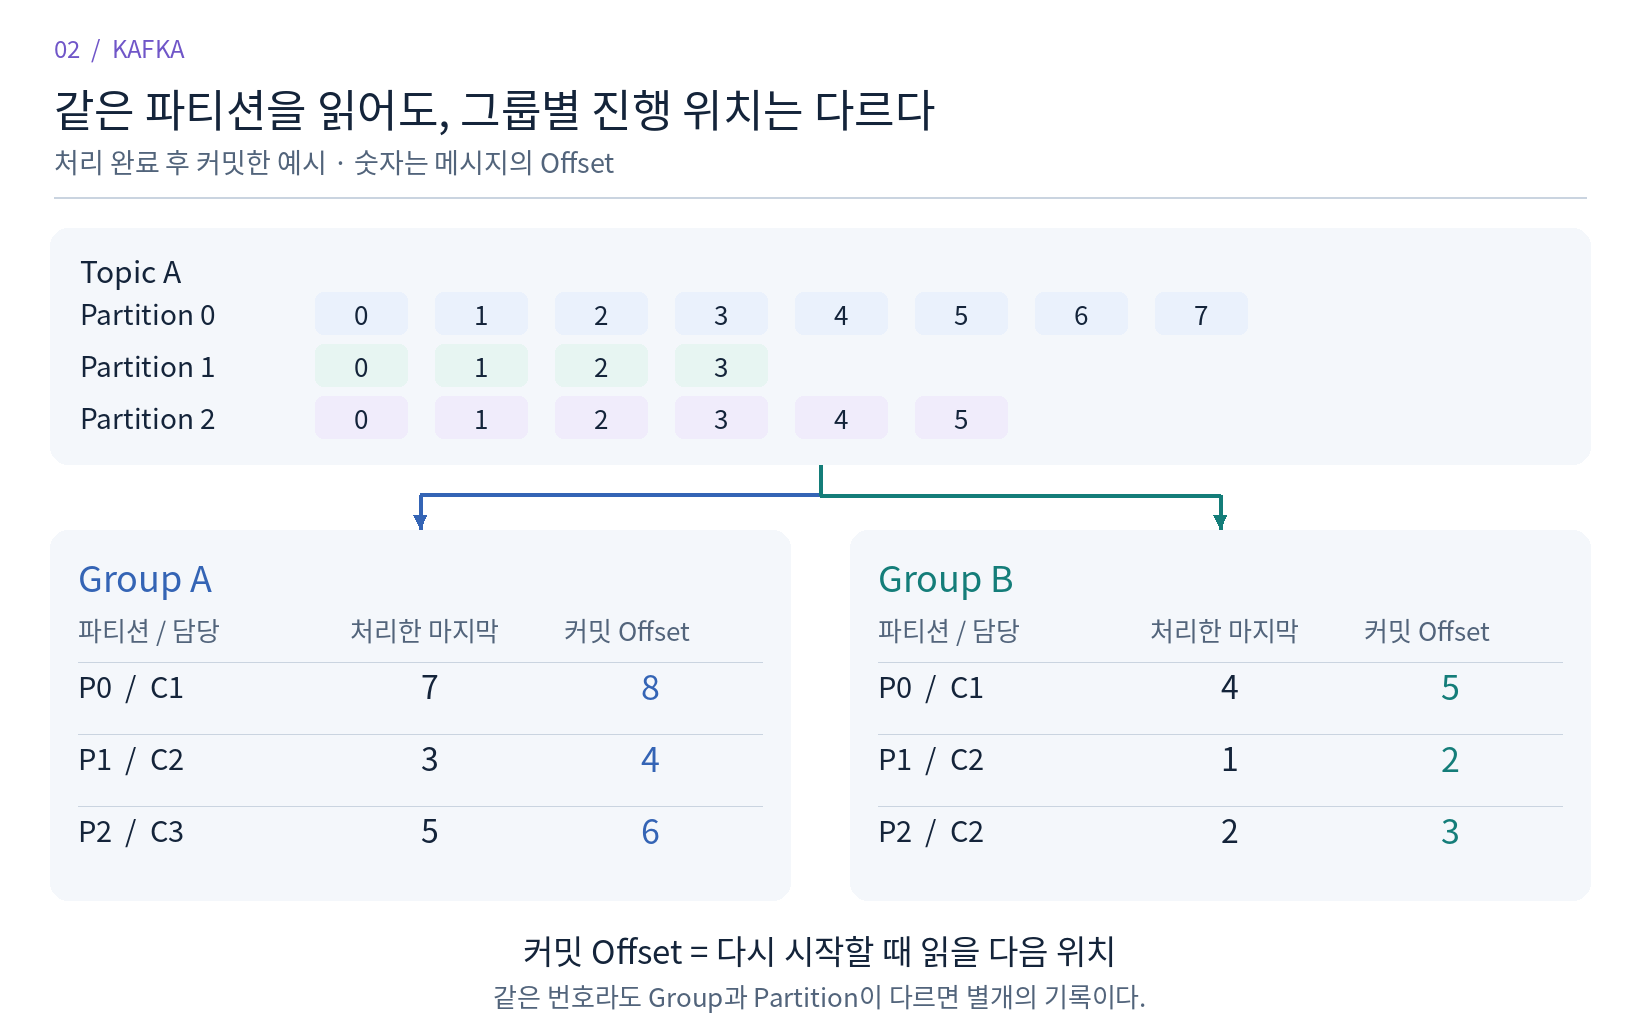
그림에서는 두 그룹이 다음과 같이 작업을 분담한다.
- Group A: Consumer 3개가 파티션을 하나씩 담당한다.
- Group B: Consumer 2개 중 하나가 파티션 0을, 다른 하나가 파티션 1과 2를 담당한다.
같은 파티션을 읽어도 진행 속도는 다를 수 있다. 예를 들어 파티션 0에서 Group A는 7번까지, Group B는 4번까지 처리를 마친 상태다.
여기서 커밋하는 Offset은 마지막으로 처리한 번호가 아니라, 다음에 읽을 위치라는 점이 중요하다.
| 상태커밋 | Offset |
| 7번까지 처리 완료 | 8 |
| 4번까지 처리 완료 | 5 |
Consumer가 커밋을 요청하면 Kafka가 해당 그룹의 위치를 저장한다. 재시작 후에는 유효한 커밋 기록과 메시지가 남아 있다면 그 위치에서 이어 읽을 수 있다. 위 예시에서 8번 메시지가 아직 없다면 새 메시지를 기다린다.
단, Offset 커밋이 중복이나 누락을 자동으로 막아 주지는 않는다. 업무 처리와 커밋 사이에 장애가 발생하면 재처리 또는 누락이 생길 수 있으므로, 커밋 시점과 중복 처리 방지도 함께 설계해야 한다.
3. 하나의 토픽을 여러 Consumer Group이 활용하기
category-click 토픽에 카테고리 클릭 이벤트를 저장한다고 가정해 보자. 이 예시에서는 이해를 돕기 위해 파티션을 1개로 둔다.
Producer가 클릭 이벤트를 발행하면, 여러 Consumer Group이 같은 이벤트를 읽어 서로 다른 작업을 수행할 수 있다.
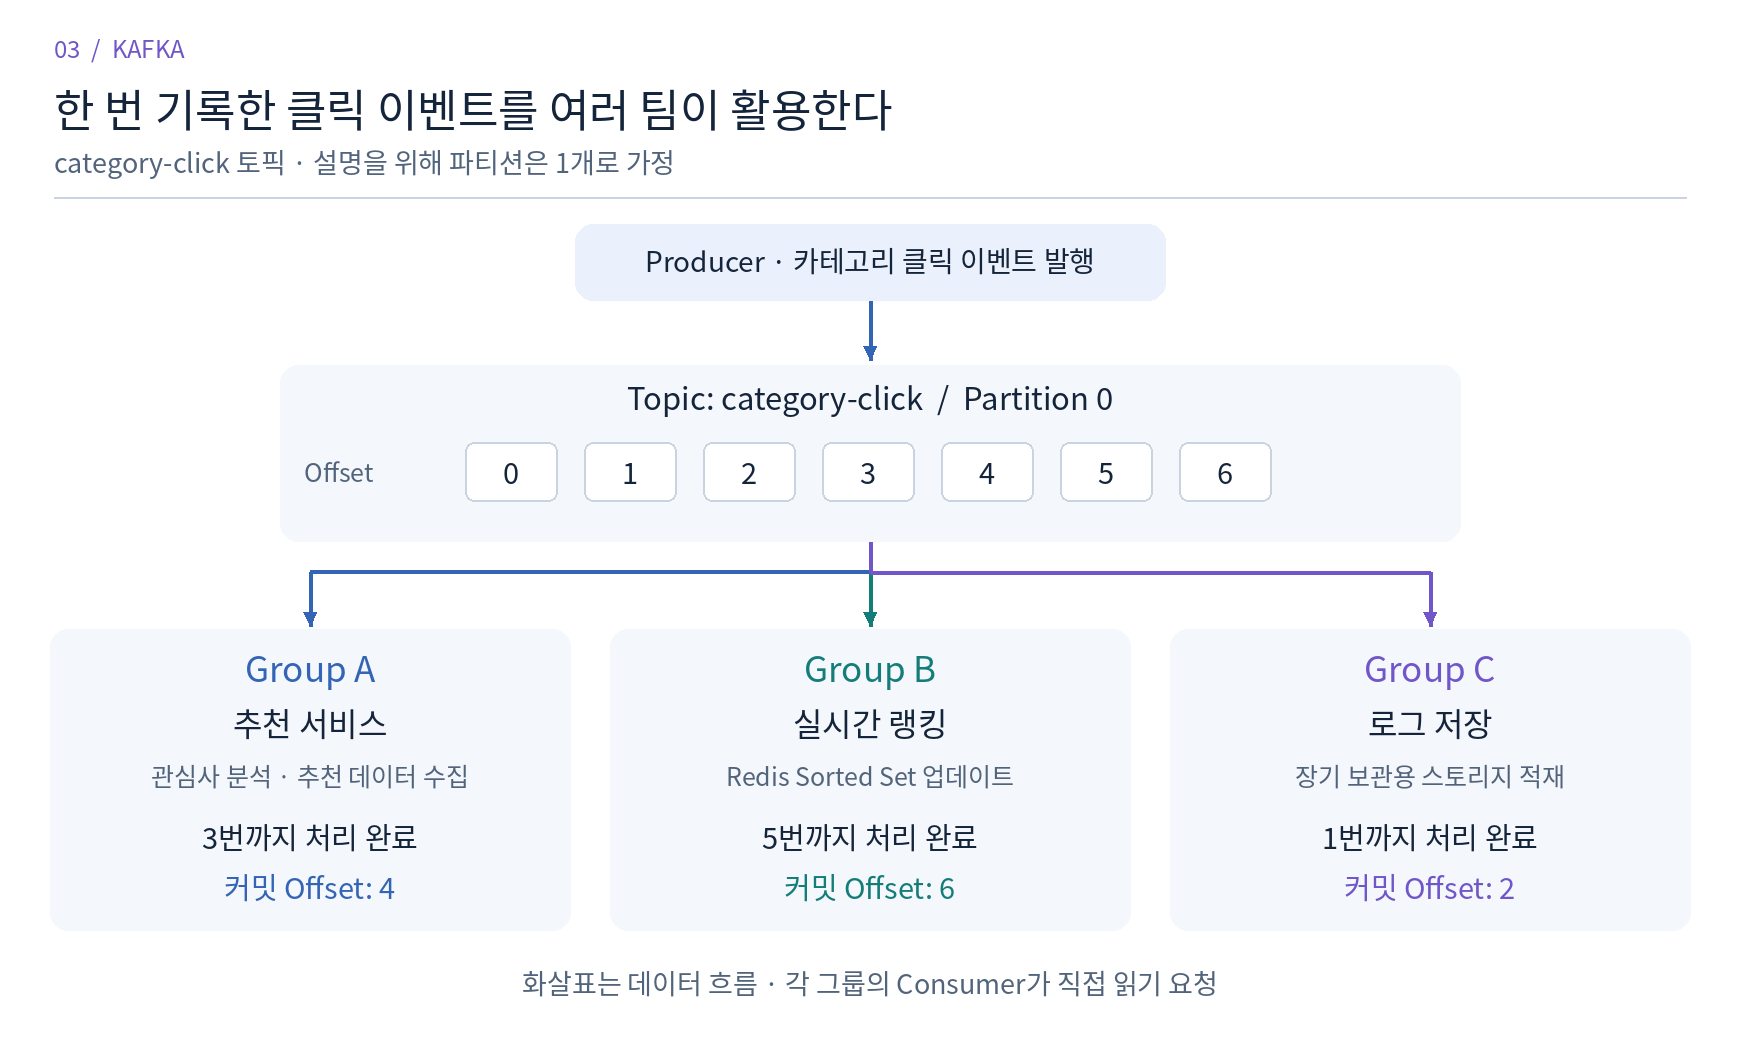
| Consumer Group | 처리 목적 | 처리한 마지막 offset 커밋 | offset |
| Group A: 추천 서비스 | 사용자 관심사 분석, 추천 데이터 수집 | 3 | 4 |
| Group B: 실시간 랭킹 | Redis Sorted Set 업데이트 | 5 | 6 |
| Group C: 로그 저장 | 장기 보관용 스토리지 적재 | 1 | 2 |
Group B가 먼저 읽었다고 Group A와 C가 해당 메시지를 읽을 수 없게 되는 것은 아니다. 각 그룹은 자신의 진행 위치에서 독립적으로 읽는다.
또한 메시지는 Consumer가 읽었다는 이유만으로 삭제되지 않는다. Kafka의 보관 정책에 따라 유지되므로 다른 그룹도 읽을 수 있다. 다만 처리가 지나치게 늦어지면 이미 삭제된 메시지를 놓칠 수 있다.
같은 그룹 안에서는 파티션을 나누어 처리하고, 서로 다른 그룹은 같은 토픽을 각자의 진행 위치에서 독립적으로 읽는다.
Kafka에 대한 흔한 오해 세 가지
- Consumer를 많이 늘리면 무조건 빨라진다.
병렬 처리는 파티션 수에 의해 결정된다. 파티션이 3개인데 Consumer가 5개면 2명은 놀기만 한다. - Kafka는 DB다.
Kafka는 저장은 하지만 조회용은 아니다. 조회가 빠른 것은 Redis이고, 저장·재처리·순서 보장은 Kafka가 담당한다. - Kafka는 이벤트를 실시간으로 처리한다.
실시간 처리를 하는 것처럼 보이지만, 실제로는 이벤트를 저장해두었다가 순서대로 처리할 수 있게 해주는 구조다.
정리
- Kafka는 Producer가 보낸 메시지를 저장해 두었다가 Consumer가 꺼내 가게 하는 분산 메시지 플랫폼이다.
- Broker는 메시지를 저장하는 서버다. 한 대만 두면 장애와 확장에 취약해서 여러 대를 묶은 클러스터로 운영한다.
- Topic은 메시지 분류이고, Topic은 여러 Partition으로 나뉘어 브로커들에 분산 저장된다. 그래서 처리량이 확장된다.
- Replica는 Partition의 복사본으로 다른 브로커에 저장된다. 브로커가 죽어도 데이터가 남는다.
- Replica 중 Leader가 읽기와 쓰기를 처리하고, Follower는 복사만 한다. Leader가 죽으면 ISR에 있는 Follower가 새 Leader가 된다.
- Controller는 클러스터의 관리자로, 브로커 상태 확인, Leader 선출, 메타데이터 관리를 맡는다. 실제로 일하는 건 Active Controller 하나다.
- 결국 Kafka는 Partition으로 나누고, Replica로 지키고, Controller로 관리한다.
'개발공부 > Kafka' 카테고리의 다른 글
| Kafka 브로커 한 대를 중지하면? 리더 전환과 ISR 변화 관찰하기 (0) | 2026.09.25 |
|---|